一句话怎么变成一张画?CLIP跨模态对齐原理用比喻讲明白
把"一只坐在沙发上的橘猫"打进AI绘画工具,回车,几十秒后屏幕上映出一只猫。流程顺得让人忘记一个很矛盾的事实——你输入的是一串文字,输出的却是一堆像素。文字和画面,本来是两种语言,中间怎么就对上了?
这里有个词经常被点到名:CLIP。它不像扩散模型那样负责"画",它干的是另一份工——让机器看懂"文字说的"和"画面画的"是同一回事。要理解它,不妨把它想象成一个翻译官。
想象一下,你站在一个能看到两个世界的观察平台上。左边是文字世界,一个个词句各有各的含义。右边是画面世界,一张张图片各有各的内容。CLIP这个翻译官的工作,就是给这两个世界的每一样东西,各贴一张"数字名片",然后把名片对齐。
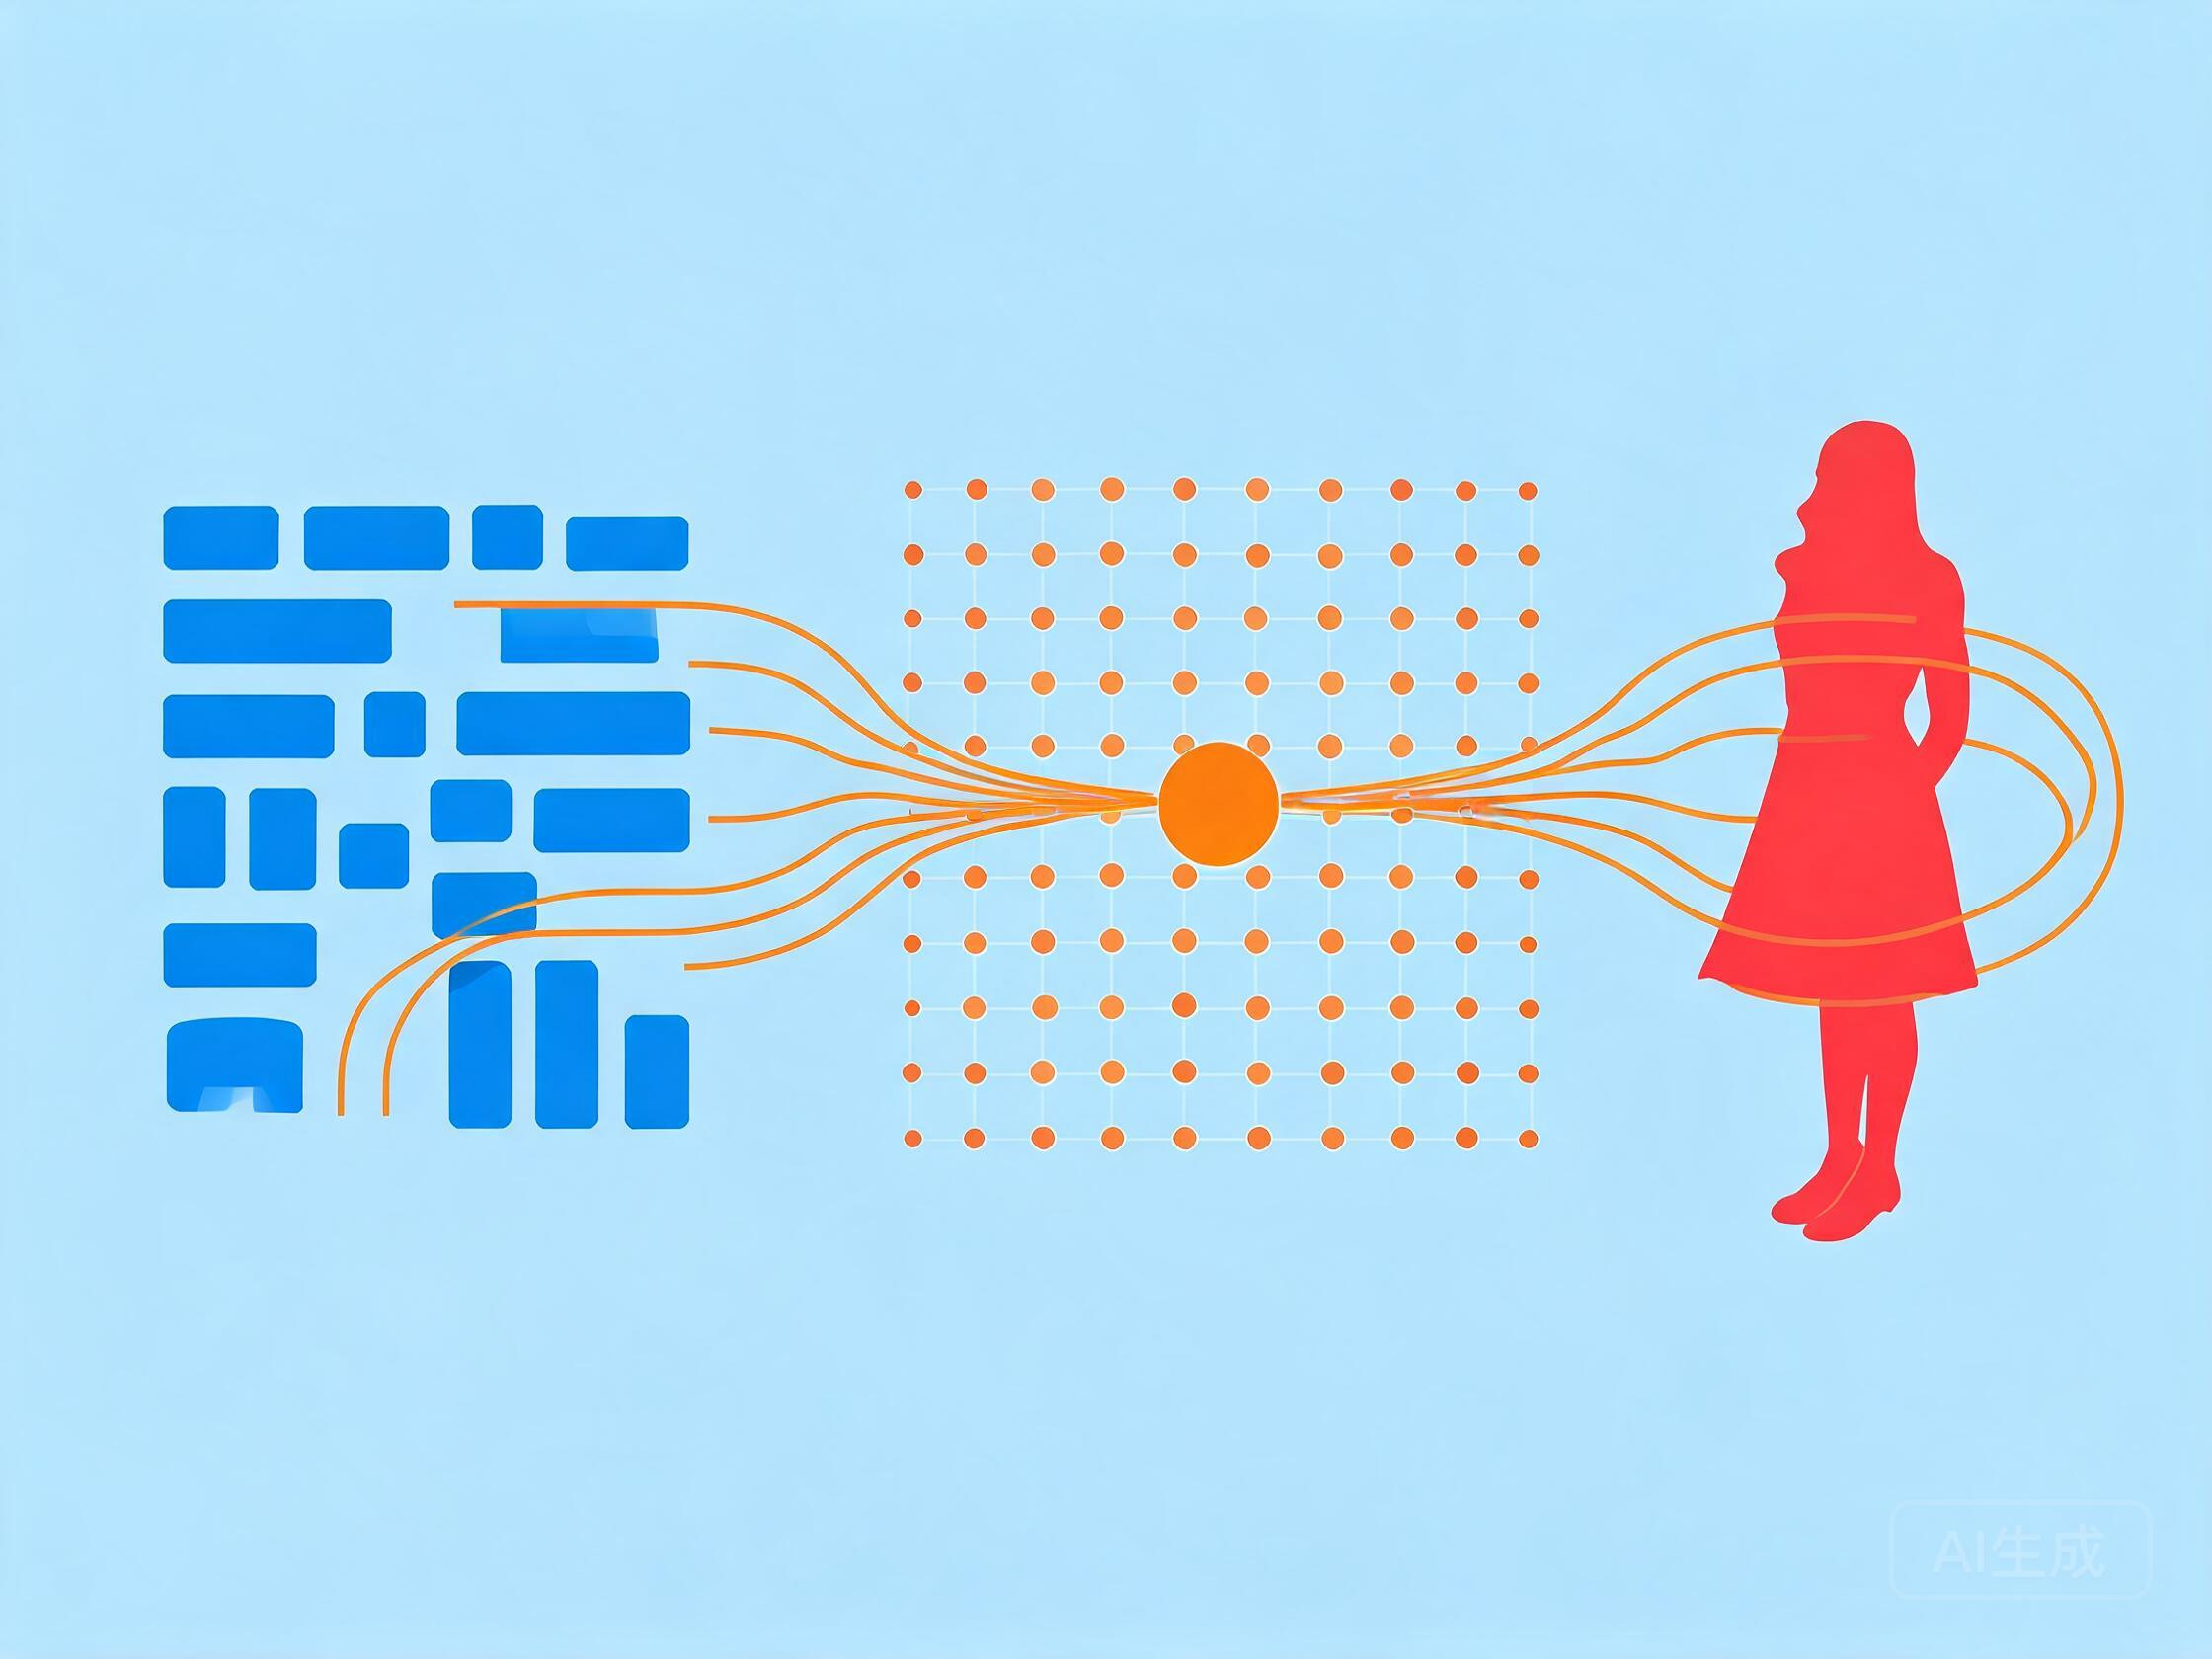
关键在"对齐"这两个字。CLIP内部有两套编码器——一套处理文字,读句子、吐出一串数字;一套处理图片,看画面、吐出一串数字。这串数字就是前面说的"名片",也是一串向量。翻译官的功夫,就是要让"一只坐在沙发上的橘猫"这串文字的名片地址,和"那张有橘猫坐在沙发上的图片"的名片地址,落在同一个地方附近。
它怎么练出这身功夫的?靠的是看海量的"图文配对"。训练样本是一张图配一句描述。每次喂进一对,CLIP就做一次"核对":把图的名片和文字的名片对比,如果讲的是同一回事,就把两者往近处拉;不是同一回事,就往外推。就这么反复练了几亿次,两个编码器被拧成了一个恰到好处的默契——见了文字,能想到跟它匹配的画面;见了画面,能说出跟它匹配的话。
有了这层"对齐",CLIP能做的事其实比大家以为的更多。AI绘画里它只是配角——负责在扩散模型画的过程中"把关",判断当前的结果跟提示词贴不贴,方向对不对,带着它往"符合描述"的画法走。扩散模型负责动手,CLIP负责看路,两件事拼在一起,才炮制出那句"橘猫"落成画面的效果。
单独把CLIP拎出来,它还能反过来用。给它一张图,它能描述这张图大概是什么——做封面审核的算法、给图打标签的工具,背后经常站着类似的跨模态模型。它甚至能帮你在一堆图里"按意思找图",你描述的是一件事,它从库里找跟你意思接近的画面,而不是只看文件名。
想深一层,文字和画面的"对齐"之所以能成立,前提是两者背后确实共享着同一个"语义"。无论用文字还是用颜色线条去表达,人类都指向同一个概念世界——猫、沙发、橘色。CLIP这个翻译官,本质上是搭了一座桥,让机器把两片各自独立的数字大陆连成了一个能互相指认的图景。
回开头那句话。它不是被"翻译"成一张画,而是它和那张画,在上千维的空间里站到了同一个位置。文字和画面从此不再各自为政,借着一个翻译官牵线,成了能对上话的邻居。
