AI其它类
让小模型学会大模型的本事:知识蒸馏原理拆解
5天前16
大模型效果好,但部署又贵又慢;小模型跑得快,能力又差一截。能不能两头都占?知识蒸馏干的正是这件事:让一个小模型(学生)去模仿一个大模型(老师)的判断,把老师的"功夫"压缩进学生的小…
大模型微调太贵?LoRA 参数高效微调原理拆解
5天前20
想拿自己领域的数据去微调一个开源大模型,一上手就撞到一堵墙:全量微调要更新模型里的每一个参数,算力和显存都顶不住,普通团队玩不转。LoRA 就是冲着这堵墙来的。它让"在大模型上做定制&quo…
为什么大模型参数这么多却不太慢?MoE 混合专家架构原理拆解
1周前 (10-05)17
这几年有个奇怪的现象:有的模型总参数大得吓人,跑起来却没想象中那么慢,训练成本还压得很低。背后的关键,很多时候就是"MoE"这三个字母——混合专家(Mixture of Exper…
大模型是怎么缩进手机里也能跑的?模型量化原理拆解(INT8/INT4 量化技术详解)
1周前 (10-05)17
一个 70 亿参数的模型,原始权重动辄要几十 GB 显存,凭什么本地电脑能跑、手机也能跑?答案绕不开两个字——量化。它几乎是大模型从"服务器里的大家伙"变成"人人能下载&…
大模型推理为什么既想快又想省显存?KV Cache的缓存账与优化拆解
1周前 (10-05)17
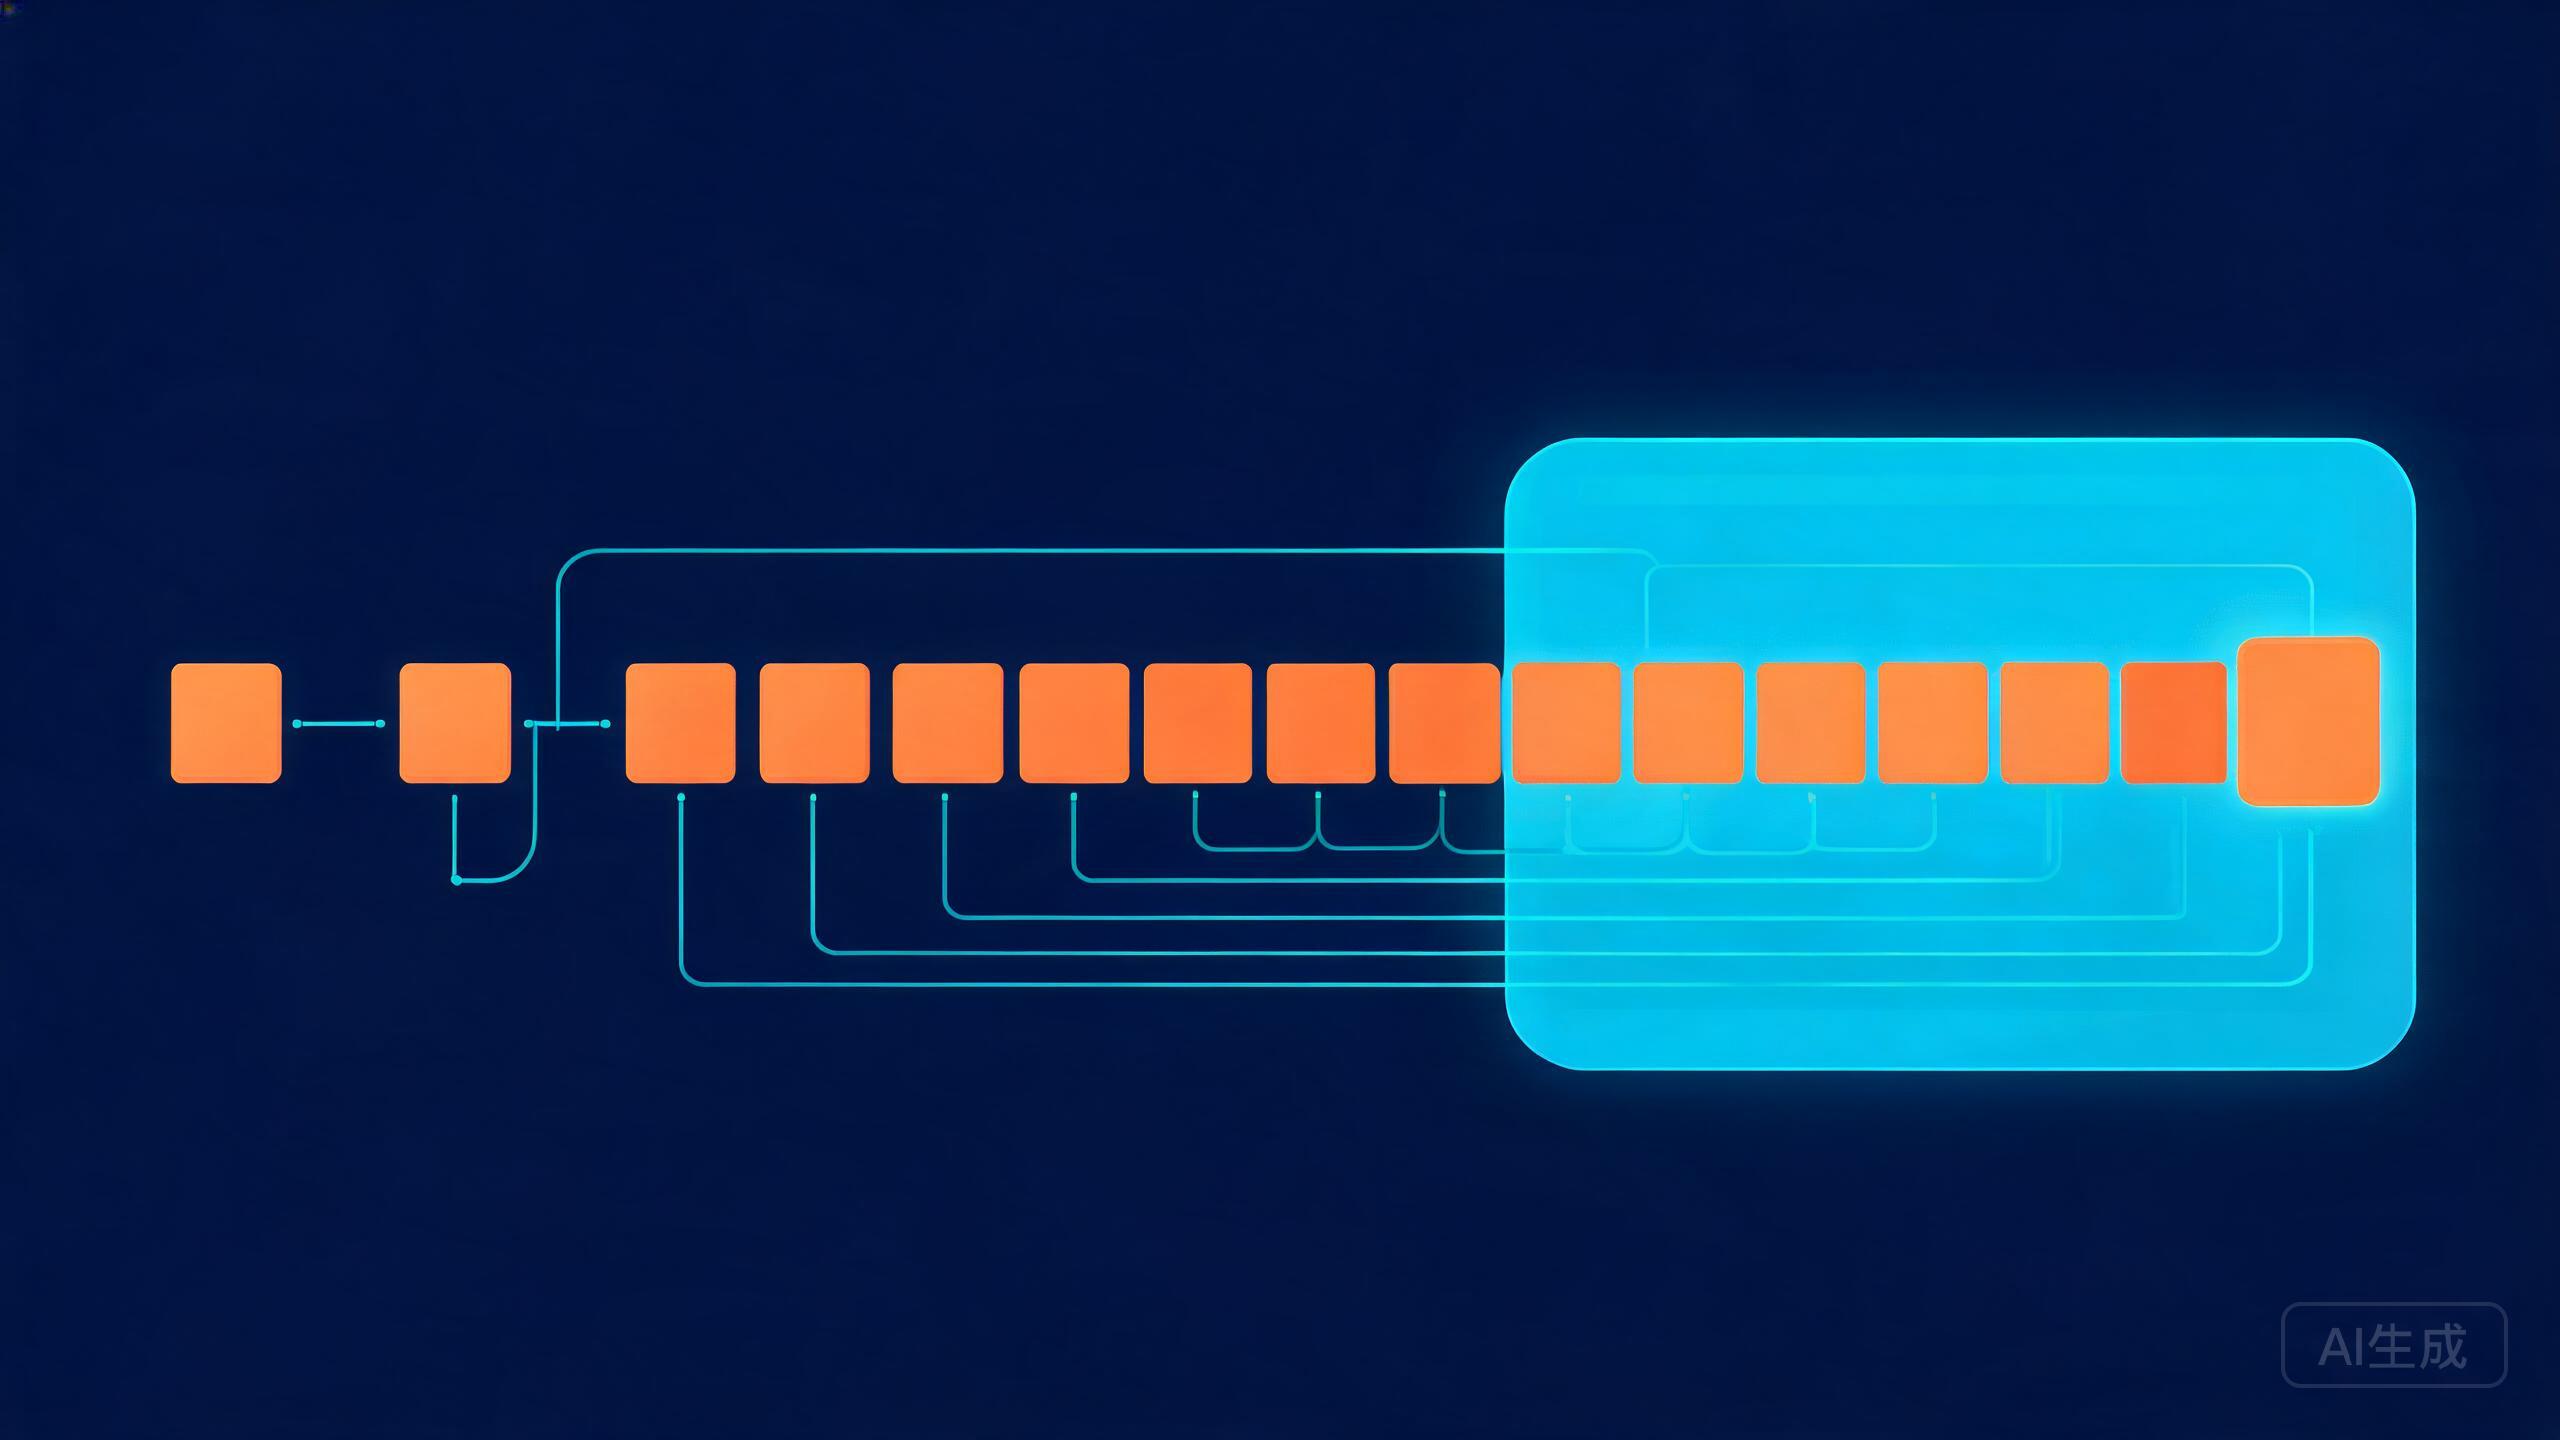
拿一个开源的 7B 模型部署对话服务,跑起来之后你会发现一个奇怪的现象:生成速度为每秒四五十个 token,显卡显存却已经吃掉了二十多 GB。按模型权重 fp16 算,7B 参数不过 14GB,剩下的…
大模型是怎么学会「说人话」的?从RLHF到DPO的偏好对齐技术演进
1周前 (10-05)15
用基础模型写一段产品介绍,你经常会得到这样的结果:语法通顺、结构工整、词藻还不差,但读起来总透着一股"不像正常人会写出来的东西"的味道。要么把一句能说完的事抻成三段,要么该收尾的地…
购物软件为什么能猜中你想买什么?从协同过滤到深度学习的推荐原理
1个月前 (09-10)53
去年某咨询公司的数字消费报告里有个数据:国内头部电商平台的推荐流量占比已经超过六成。翻译成大白话——你在购物软件上看到的东西,一大半不是自己搜的,是算法递到你眼前的。这个比例三年前还不到四成。…
数字人直播带货能赚到钱吗?看了一圈真实案例,水有点深
2个月前 (08-25)49
晚上十一点多刷直播,刷到一个卖零食的直播间。主播是个年轻女生,声音清脆,语速很快,一直在介绍一款坚果礼盒。我看了大概五分钟,总觉得哪里不太对——她的眨眼频率特别均匀,大概每三秒眨一次,不多不少。…
AI智能体跟普通AI聊天到底差在哪?一个例子就懂了
2个月前 (08-25)46
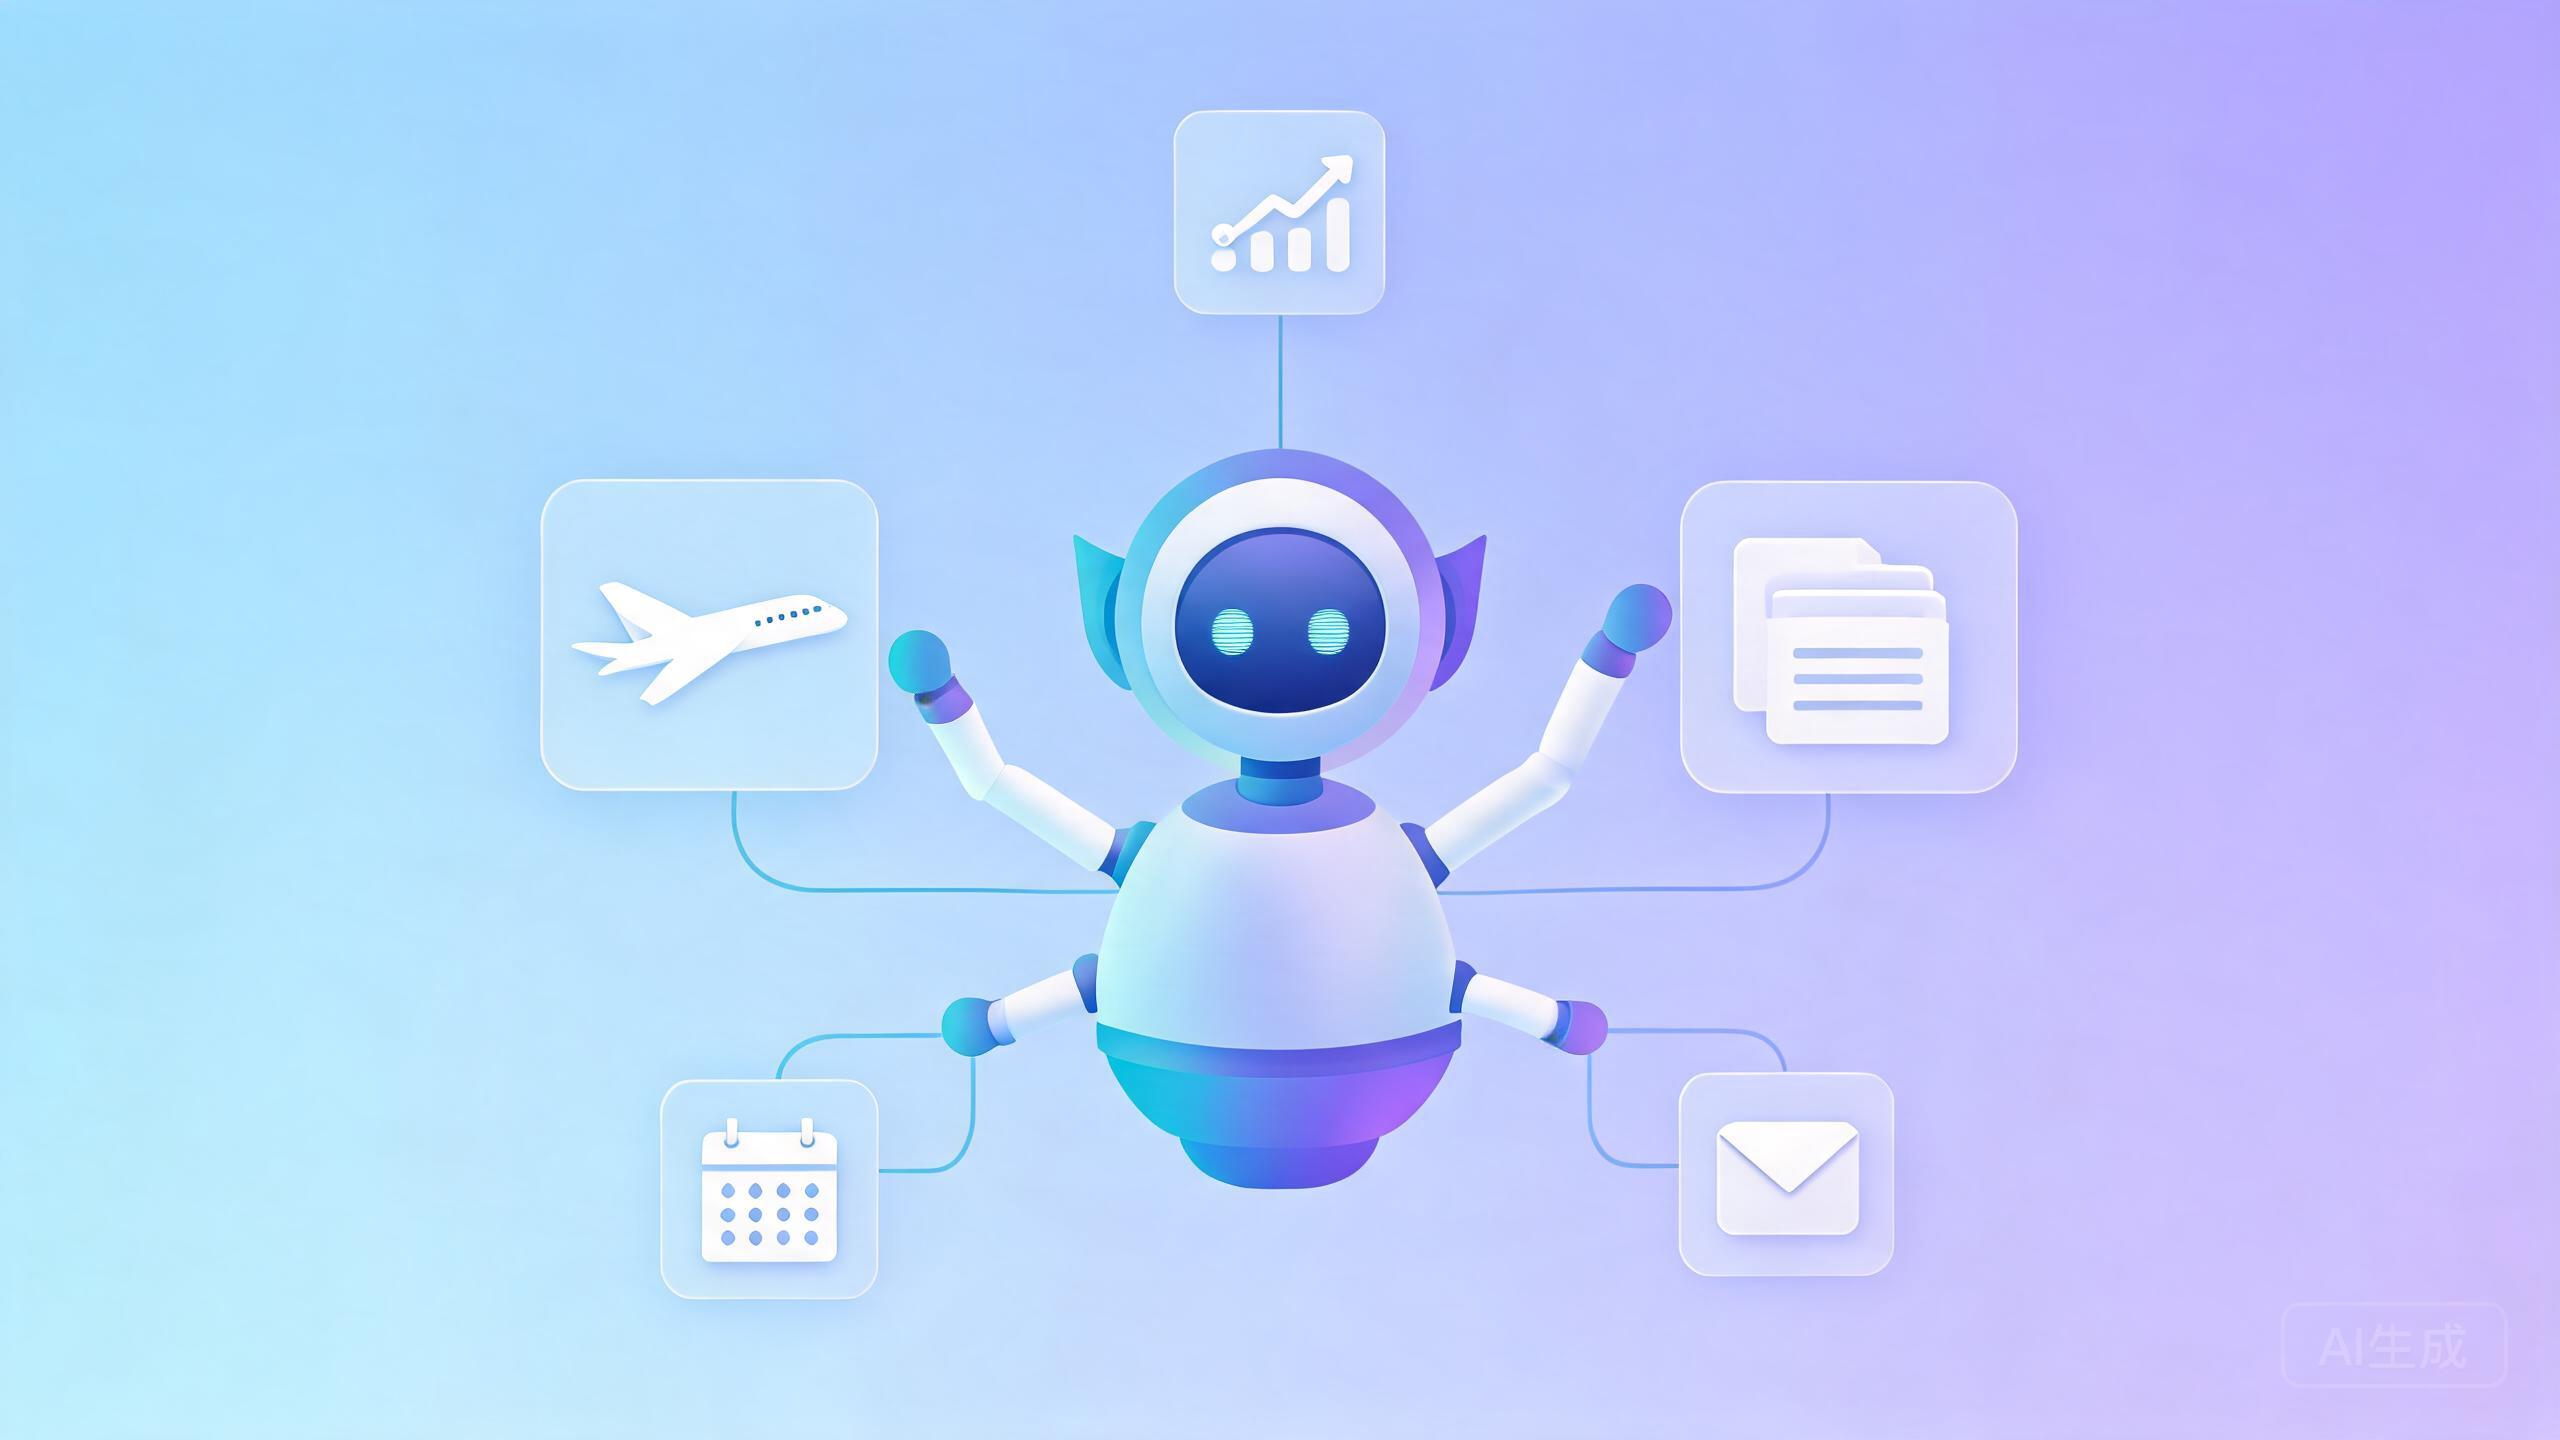
前段时间朋友问我一个问题:"ChatGPT不是已经很强了吗,为什么又冒出来一个AI智能体?这两个到底有什么区别?"我当时举了个例子。我说你现在问ChatGPT"帮我查一下…
AI视频生成为什么只有几秒?不是限制你,是再长就崩了
2个月前 (08-20)57
AI视频生成为什么只有几秒?不是限制你,是再长就崩了打开任何一个AI视频生成工具,你会发现一个共同点——单次生成基本卡在5到15秒。Sora 2是20秒封顶,可灵3.0是15秒,即梦和Vidu大多在5…