大模型推理为什么既想快又想省显存?KV Cache的缓存账与优化拆解
拿一个开源的 7B 模型部署对话服务,跑起来之后你会发现一个奇怪的现象:生成速度为每秒四五十个 token,显卡显存却已经吃掉了二十多 GB。按模型权重 fp16 算,7B 参数不过 14GB,剩下的十来个 GB 去哪了?
答案藏在一个不起眼的结构里——KV Cache。它既是让自回归生成能跑快的关键,又是把显存撑爆、把长文本成本拉高的元凶。这篇把它是什么、占多大、怎么省,逐层拆开。
自回归生成里,藏着大量的重复计算
大模型生成文本是逐个 token 来的。生成第 1 个词时,模型读入全部输入;生成第 2 个词时,要读入"全部输入 + 第 1 个词";生成第 3 个词时,又要读入"全部输入 + 前两个词"。随着输出变长,每一步重算的前缀越来越长。
如果每一步都老老实实把前面的内容重新编码一遍,输出 100 个 token 就相当于把整个上下文算了 100 遍,算力浪费得离谱。
落点是注意力的机制本身。解码阶段,当前 token 只需要关注它前面的所有位置——也就是已生成的 K、V 向量。这些 K、V 在生成历史 token 的时候已经算出来过了,没必要每次都重算,直接存起来复用即可。存下来的这份张量,就是 KV Cache。
为什么能缓存:注意力只往前看
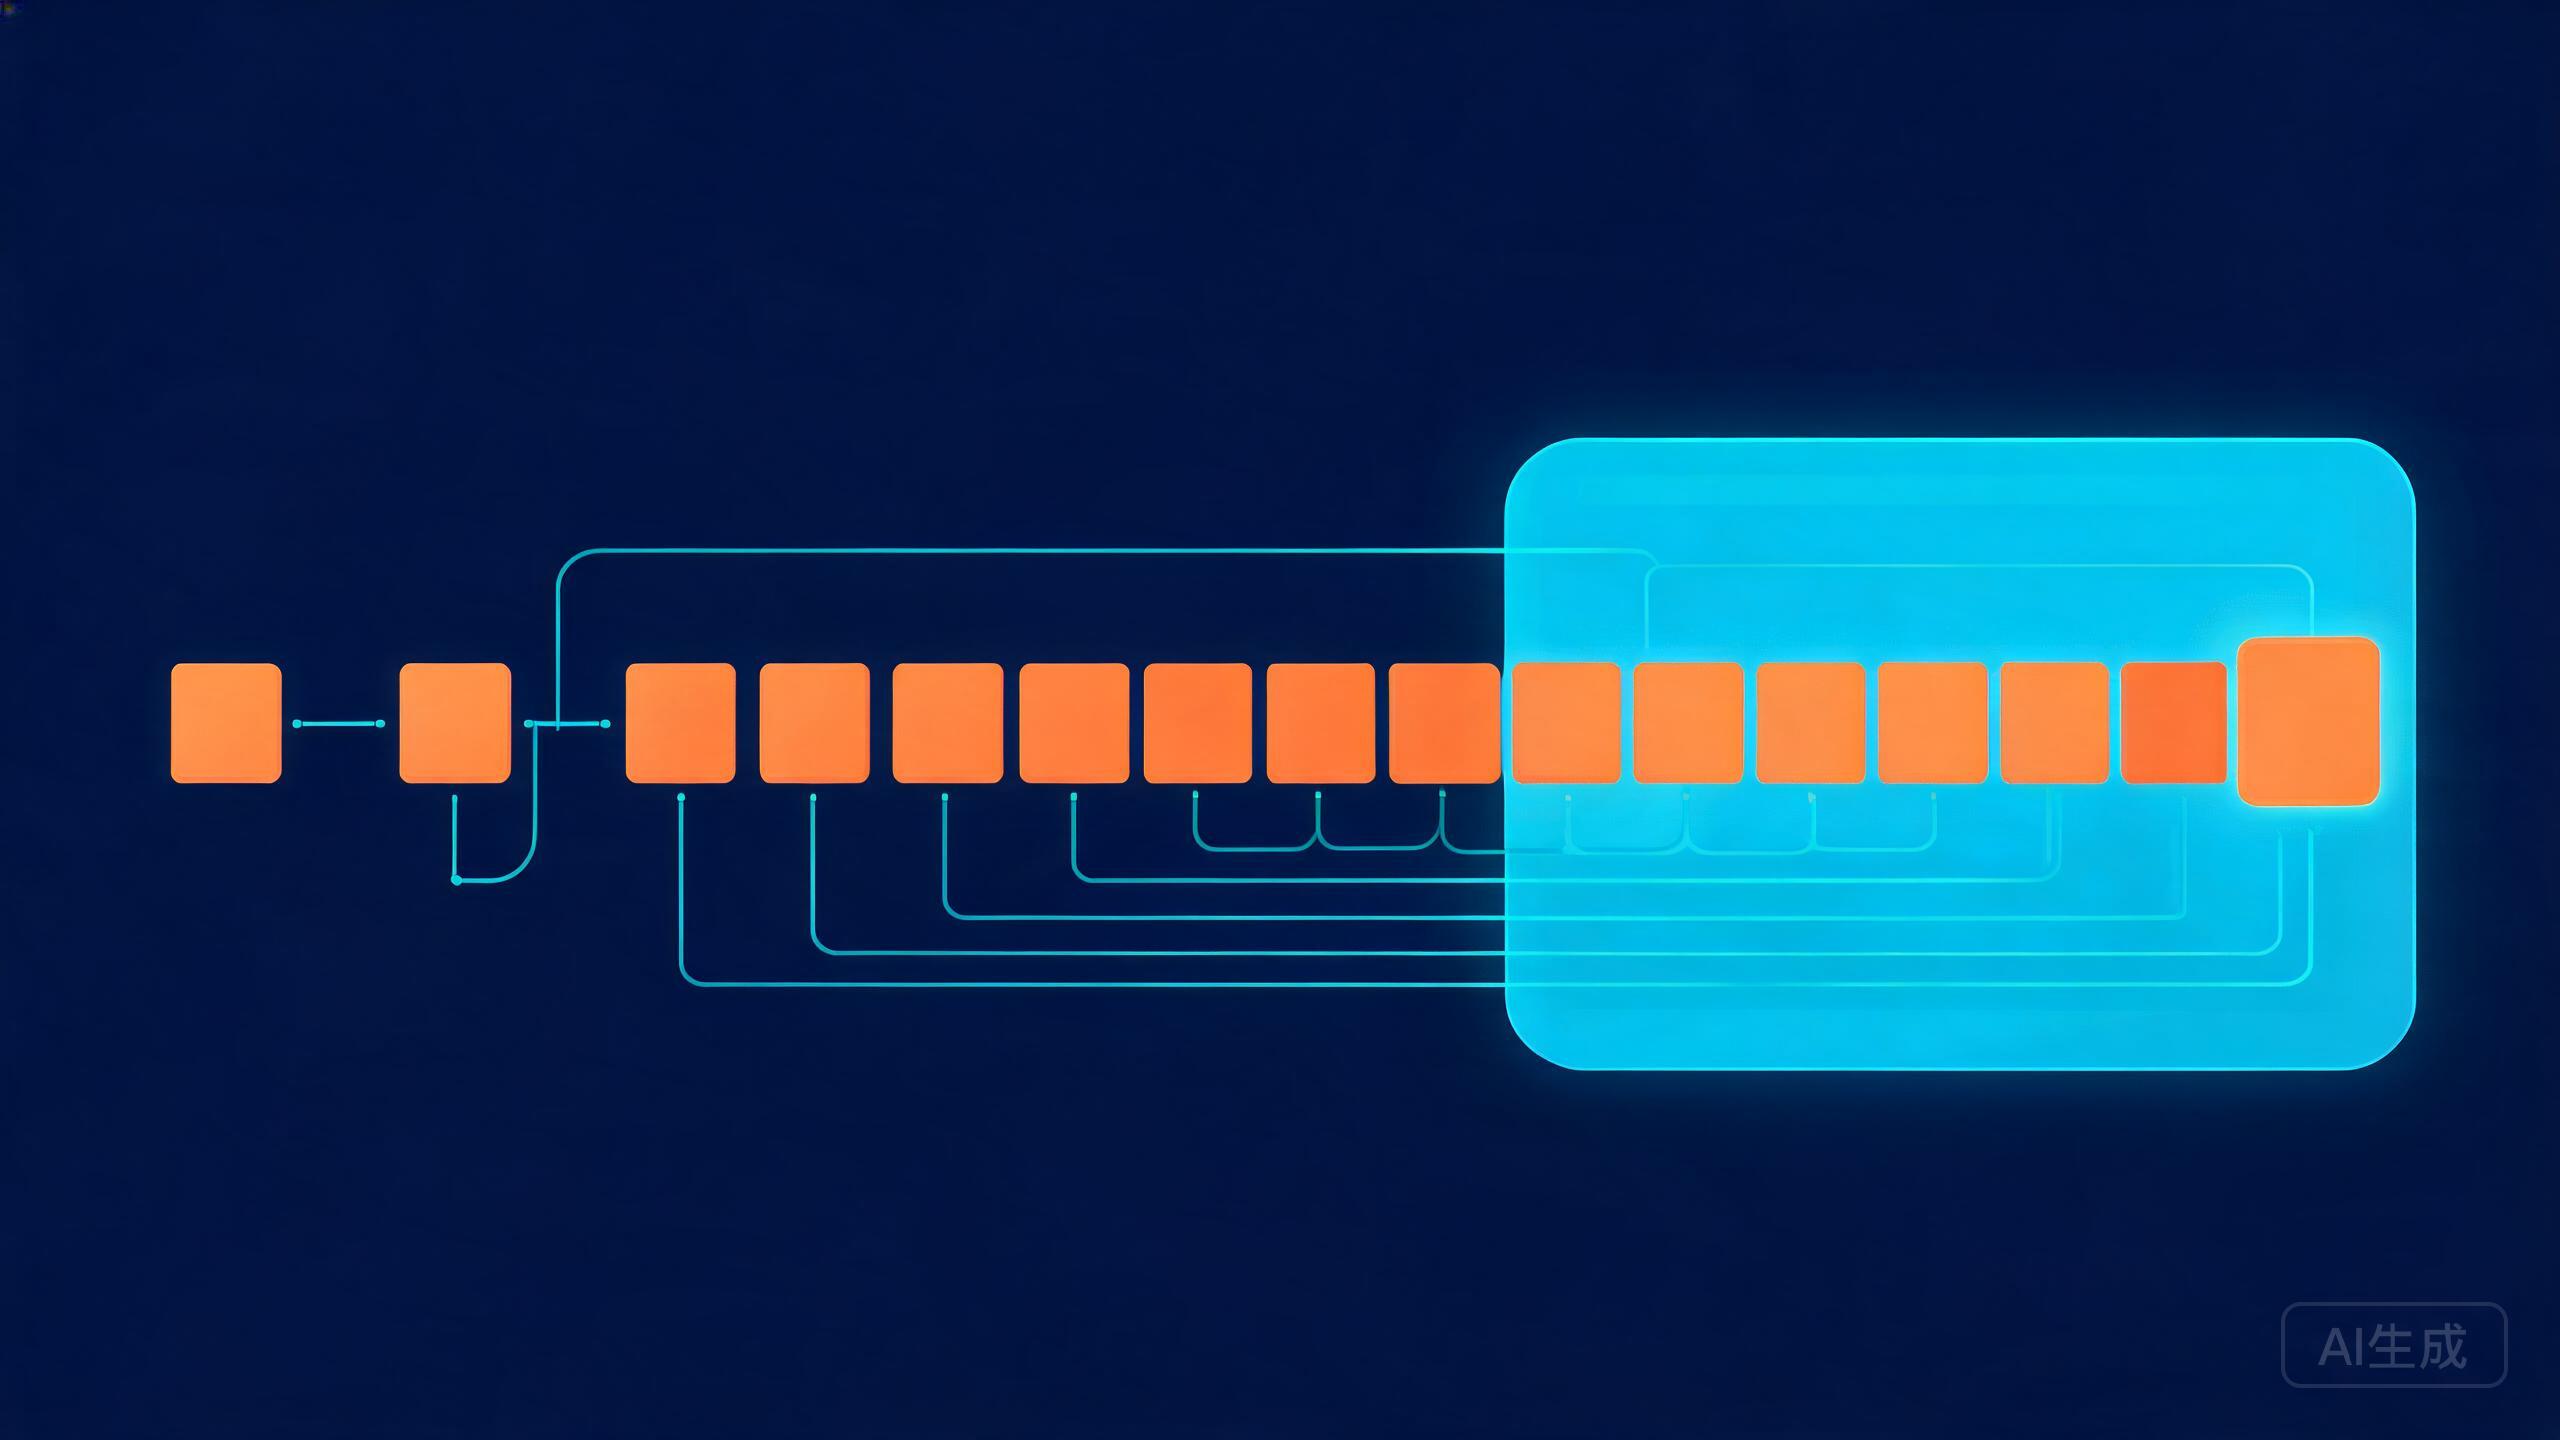
能缓存的前提,是解码时的注意力是"因果的"——当前 token 只能看到自己以及它前面的位置,看不到后面的。这意味着一个位置的 K、V 一旦算出来,它对后续所有位置的贡献就固定了,不随上下文继续变长而改变。
于是推理可以在单步内这么做:把新 token 的 q 拿进来,跟"已有的 K、V"以及"新 token 自己的 k、v"做注意力,算完把新的 k、v 追加进缓存。前缀部分一步到位复用,每一步要算的量基本只和一个新 token 有关。
写成伪代码是这个样子:
# 每一步只处理一个新 token,前缀靠缓存复用
def decode_step(q_new, k_new, v_new, cache):
    K = concat(cache.K, k_new)       # 历史K + 新K
    V = concat(cache.V, v_new)       # 历史V + 新V
    out = attention(q_new, K, V)     # 只对当前q算一次注意力

    cache.append(k_new, v_new)       # 新k/v写回,供下一步使用
    return out
这里的复杂度变化很关键:不做缓存时,每一步的算量随序列长度平方级增长;做了缓存,每一步只新增一个位置的注意力,算量随序列长度线性增长。长文本下,这个差距是数量级的。
缓存到底占多大:把账摊开算
KV Cache 存的是每一层、每个注意力头、每个位置上的 K 和 V 张量。它的体量可以精确算出来:
KV Cache 大小 = 2 × 层数 × KV头数 × 序列长度 × 头维度 × 字节数

其中那个 2,代表 K 和 V 各存一份。
拿一个常见的配置代进去:32 层,32 个 KV 头,头维度 128,序列长度 4096,参数用 fp16(每元素 2 字节)存:
| 项 | 取值 |
|---|---|
| 层数 | 32 |
| KV 头数 | 32 |
| 头维度 | 128 |
| 序列长度 | 4096 |
| 数据类型 | fp16(2 字节) |
| K 与 V 两份 | 2 |
乘起来:2 × 32 × 32 × 4096 × 128 × 2,结果约 2.0 GB。这还只是序列长度 4096、单个请求的情况。显存账的关键就在这里——KV Cache 不是固定开销,它跟序列长度成正比。上下文翻一倍,缓存就翻一倍;同时来 8 个并发请求,缓存就乘 8。
而且注意,序列长度是"输入长度 + 已生成长度"之和。一个 4000 token 的输入,生成到 4096 时,长度其实已经顶到了 8000 多。很多人算显存时只盯着输入长度,忽略了生成过程也在持续膨胀缓存,到后面才发现显存不够。
省缓存的三条路
搞清了账,省的方向就清楚了。公式里的那几个乘数,每一个都能动。
头数这一项,是省得比较多的一路。GQA(分组查询注意力)让多个查询头共享同一组 KV 头,MQA(多查询注意力)更进一步,让所有查询头共用一套 KV。KV 头数从 32 降到 8,缓存直接砍到四分之一;降到 1,砍到三十二分之一。代价是表达力略降,但对多数生成任务影响可控,所以成了主流模型普遍采用的结构。
序列长度这一项,靠的是分页。PagedAttention 把隐式管理的一大块连续缓存,拆成一小块一小块的非连续页,按需分配。好处有两个:一是减少碎片,原本分配了用不满的空间能被别的请求复用;二是可以近似达到"按实际占用计费",而不是按峰值预留,同样的显存能服务的并发数更高。
字节数这一项,靠的是量化。KV Cache 训练结束后照样可以被压成 int8 乃至 int4,显存直接对半再对半。它的难点在于,量化误差会顺着注意力累积,到超长序列时有时会出现精度问题,所以 KV 量化通常比权重量化更谨慎,常配合校准或分组缩放来做。
| 优化手段 | 作用对象 | 大致收益 | 代价 |
|---|---|---|---|
| GQA / MQA | KV 头数 | 降到 1/4 ~ 1/32 | 注意力表达力略降 |
| PagedAttention | 序列分配方式 | 提升并发利用率 | 实现复杂度上升 |
| KV 量化 | 每元素字节数 | 降到 1/2 ~ 1/4 | 可能引入精度损失 |
| 滑动窗口 / 丢弃 | 序列长度 | 截断长上下文 | 丢失靠前的信息 |
什么时候 KV Cache 会成为瓶颈
想把缓存问题定位清楚,得分开看两个场景。
短输入、短输出时,瓶颈通常在算力。模型前向里矩阵乘占大头,KV Cache 还不大,优化它带来的显存收益有限。
一旦输入变长、生成变长、并发变多,缓存体积线性甚至接近二次地涨,瓶颈就转移到了显存容量和带宽上。这时候同样的卡,能塞下多少并发请求、能不能吃下超长上下文,几乎由 KV Cache 决定。很多服务在长文本下吞吐骤降,翻日志会发现并不是模型算不动,而是显存先到了上限,请求只能排队。
所以常见的做法是两头一起看:短文本场景优先优化前向算力和批处理;长文本、高并发场景,把力气花在 GQA、分页、量化这一串缓存优化上。哪里是瓶颈,就从哪里下手,而不是无差别地堆某一项。
小结
KV Cache 这件事,本质是一笔时间换空间的账。自回归生成里,每一步都要看前面的全部位置,与其反复重算,不如把已经算出的 K、V 存起来复用——这是它存在的理由。而存储是有代价的:缓存体积等于"2 × 层数 × KV头数 × 序列长度 × 头维度 × 字节数",随序列长度和并发线性膨胀,是长文本推理显存压力的主要来源。
理解了这条公式,各种优化的动机就都串起来了。GQA、MQA 是在砍头数,PagedAttention 是在改分配方式,KV 量化是在压字节数。它们动作不同,瞄准的都是同一笔账里的不同乘数。
