大模型是怎么缩进手机里也能跑的?模型量化原理拆解(INT8/INT4 量化技术详解)
一个 70 亿参数的模型,原始权重动辄要几十 GB 显存,凭什么本地电脑能跑、手机也能跑?答案绕不开两个字——量化。它几乎是大模型从"服务器里的大家伙"变成"人人能下载"的关键一环。
这篇先摊一张"参数精度账",看清楚量化到底省在哪,再拆它的做法、公式,以及那个让它没法无痛省钱的难点。
先算一笔账:为什么精度一变,体积就砍半
大模型的大小,本质上是"参数量 × 每个参数占的字节数"。参数量是模型的固有容量,动不了;能动手的,是每个参数用多少个字节存。
训练和保存时,权重常用 FP32 浮点数,一个参数占 4 字节;常用的半精度 FP16 或 BF16,一个参数占 2 字节;要是换成 INT8 整数,一个参数只占 1 字节;再狠一点到 INT4,一个参数只占半个字节。
拿 70 亿参数(7B)模型套进去算,差别立刻出来:
FP32(4 字节):7B × 4 ≈ 28 GB
FP16(2 字节):7B × 2 ≈ 14 GB
INT8(1 字节):7B × 1 ≈ 7 GB
INT4(0.5 字节):7B × 0.5 ≈ 3.5 GB
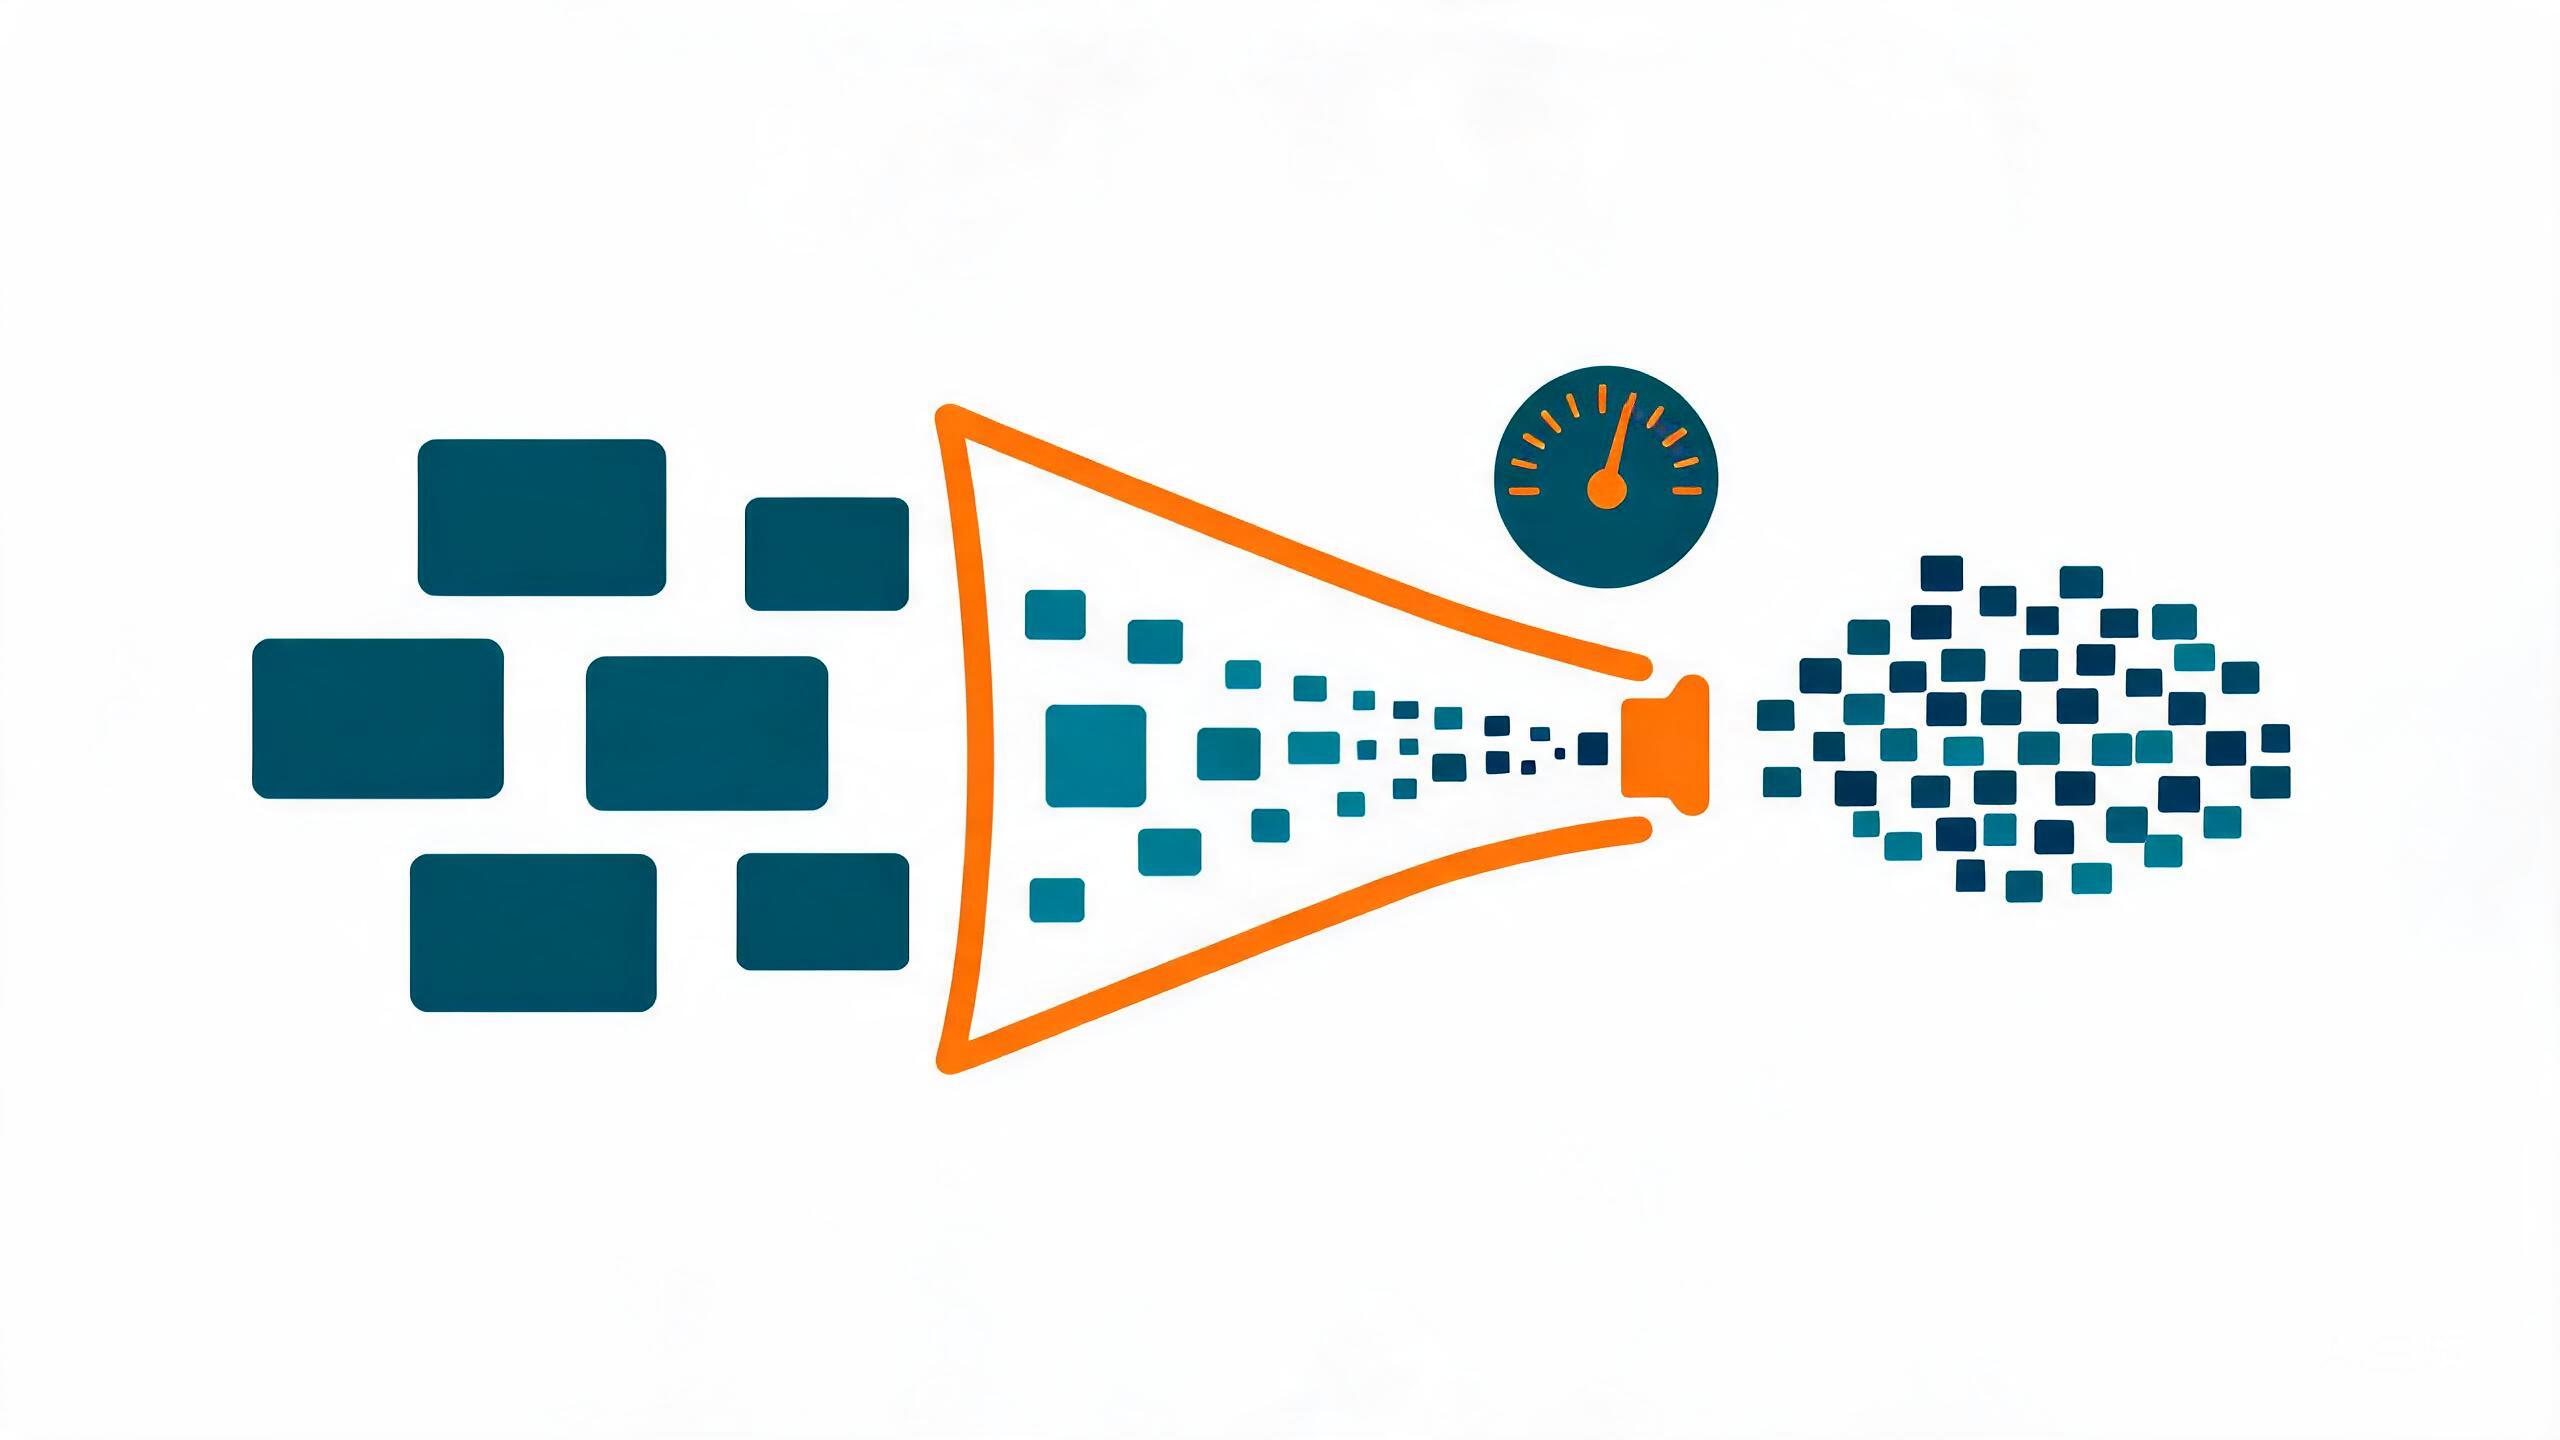
从 28GB 压到 3.5GB,中间砸掉的,就是 8 倍的存量和对应的读写开销。这一压缩,本地显卡装得下、手机内存也够得着,推理自然就落地了。量化的本质,就是把每个权重从高精度浮点数,映射成一个低精度的整数。
怎么把小数塞进整数:scale 和 zero point
核心动作不算玄:给定一组待量化的数值,先确定它们的范围,再用两个参数把"连续的小数轴"映射到"有限的整数格"上。
一个简单写法是这样:
q = round(x / scale) + zero_point
其中 x 是原始浮点数,scale 是缩放系数,zero_point 是零点偏移,q 是量化出来的整数。反过来还原时,用 `x ≈ (q − zero_point) × scale` 把整数还原成一个近似的小数。
这里分出两种做法。对称量化,假定数值大致以零为中心,把 zero_point 直接定成 0,只要一个 scale,实现简单;非对称量化,允许零点不落在零上,多一个 zero_point,能更贴合偏到一边的分布,比如很多激活值其实是正的。
问题也摆在明面上:整数格数是死的,INT8 只有 256 个可取值。原本文本量级的小数,被拍进 256 个档位,必然有舍入误差。换句话说,量化是有损压缩——省下的每一半体积,都是用"一点点精度"换来的。
PTQ 还是 QAT:量化这事,什么时候做
按"什么时候量化",主流分两条路。
一条是训练后量化(PTQ,Post-Training Quantization):模型训练完了,直接套量化转换,用一小份校准数据确定 scale。优点是省事,不用重训;缺点是精度可能掉,尤其量化到 INT4 这种低位时。
另一条是量化感知训练(QAT,Quantization-Aware Training):在训练期间就模拟量化的舍入,让模型提前适应低精度带来的误差。精度通常更稳,代价是得重新训练、成本高,多数人是能 PTQ 就先用 PTQ,不行再上 QAT。
量化的坎,几乎都出在「离群值」上
量化听起来直白,真到工程里,掉点往往不是均匀的,而是被少数"离群值"给搅的。
原因是 scale 得覆盖整个数值范围。如果某一两个维度的数值特别大,scale 就被撑得很大,结果是——其余那些正常大小的数,除以一个大 scale 之后全部挤在零附近,量化后几乎分不出差别,信息一起被磨平。一个离群值,能拖累一整片。
于是有了专门对付它的办法。LLM.int8() 的思路是"分开处理":把少数离群维度挑出来,仍按 FP16 算,其余大部分按 INT8 算,两头各吃各的精度。后续的 AWQ 这类"激活感知量化",则在量化时参考激活值的分布,给更重要的通道保留更多精度,尽量把敏感信息护住。
落到本地,那些 GGUF、GPTQ、AWQ 是什么
上手本地跑模型的人,都会撞见几个格式名,这里顺带理一下。
GGUF 是 llama.cpp 这一派用的格式,把量化后的权重和元数据打成一个文件,配上 Q4_K_M、Q5_K_M 这类档位名,老百姓下载"多大显存跑多大模型",主要靠它。
GPTQ 是偏训练后量化的经典路线,在 INT3/INT4 里用得广;AWQ 是上面说的激活感知量化,侧重保住重要通道,在低位量化上口碑不错;还有 bitsandbytes 这类库,能把加载的模型当场转成 4-bit 或 8-bit,拿来减少显存占用很方便。
它们各自的算法和适用场景不同,但目标一致:用更少的字节,装下能用的模型。
小结
把量化收一下:省体积靠的是降低"每个参数的字节数",7B 模型从 FP32 的 28GB 压到 INT4 的 3.5GB;做法是用 scale 和 zero_point 把浮点映射到有限整数格,本质上是有损压缩;按时机分 PTQ 和 QAT,按结构分对称与非对称;难啃的坎是离群值撑大 scale、磨平正常值,于是有了 LLM.int8() 的分离处理和 AWQ 的激活感知;落到本地,就化成 GGUF、GPTQ 这些大家耳熟的格式。
下次下载一个"4GB 的 7B 模型",就知道这 4GB 是怎么来的了——它不是原始模型,是原始模型被有选择地、有代价地压缩过之后的样子。
