多智能体协作怎么编排?几种拓扑结构、通信机制与失败模式拆解
一个团队把办公流程改造成多智能体系统:检索文档的负责查资料,写作的负责出初稿,审核的负责挑错,三个智能体各管一段。上线之后问题来了——审核智能体每次都提意见,写作智能体每次都改,改完审核又有新意见,两边来回拉锯十几轮,任务栏一直转,token 账单却在稳步上涨。跑到后面,执行了二十多步,产出还不如开头那版。
这不是模型能力不够,是编排出了问题。多个智能体凑在一起,复杂度不是简单相加,而是体现在"谁跟谁说话、按什么顺序、什么时候停"这些结构问题上。这篇按拓扑、通信、失败模式三层,把这件事拆开说。
单智能体为什么会顶不住
先说清楚为什么非要多智能体。单个智能体处理复杂任务时,会撞上两堵墙。
一是上下文被塞满。办公场景的输入往往很长——几十页的制度文档、上百条的工单记录,全塞进一个对话窗口,模型关注力被摊薄,容易顾此失彼。
二是角色冲突。让同一个模型既当"创作者的创意发散"又当"审核者的严格挑错",两套指令会互相干扰。它写的时候就放不开,审的时候就狠不下心。
把任务拆开、交给职责单一的智能体,能同时缓解这两个问题。代价是引入了新的协调成本,也就是下面要讲的编排。
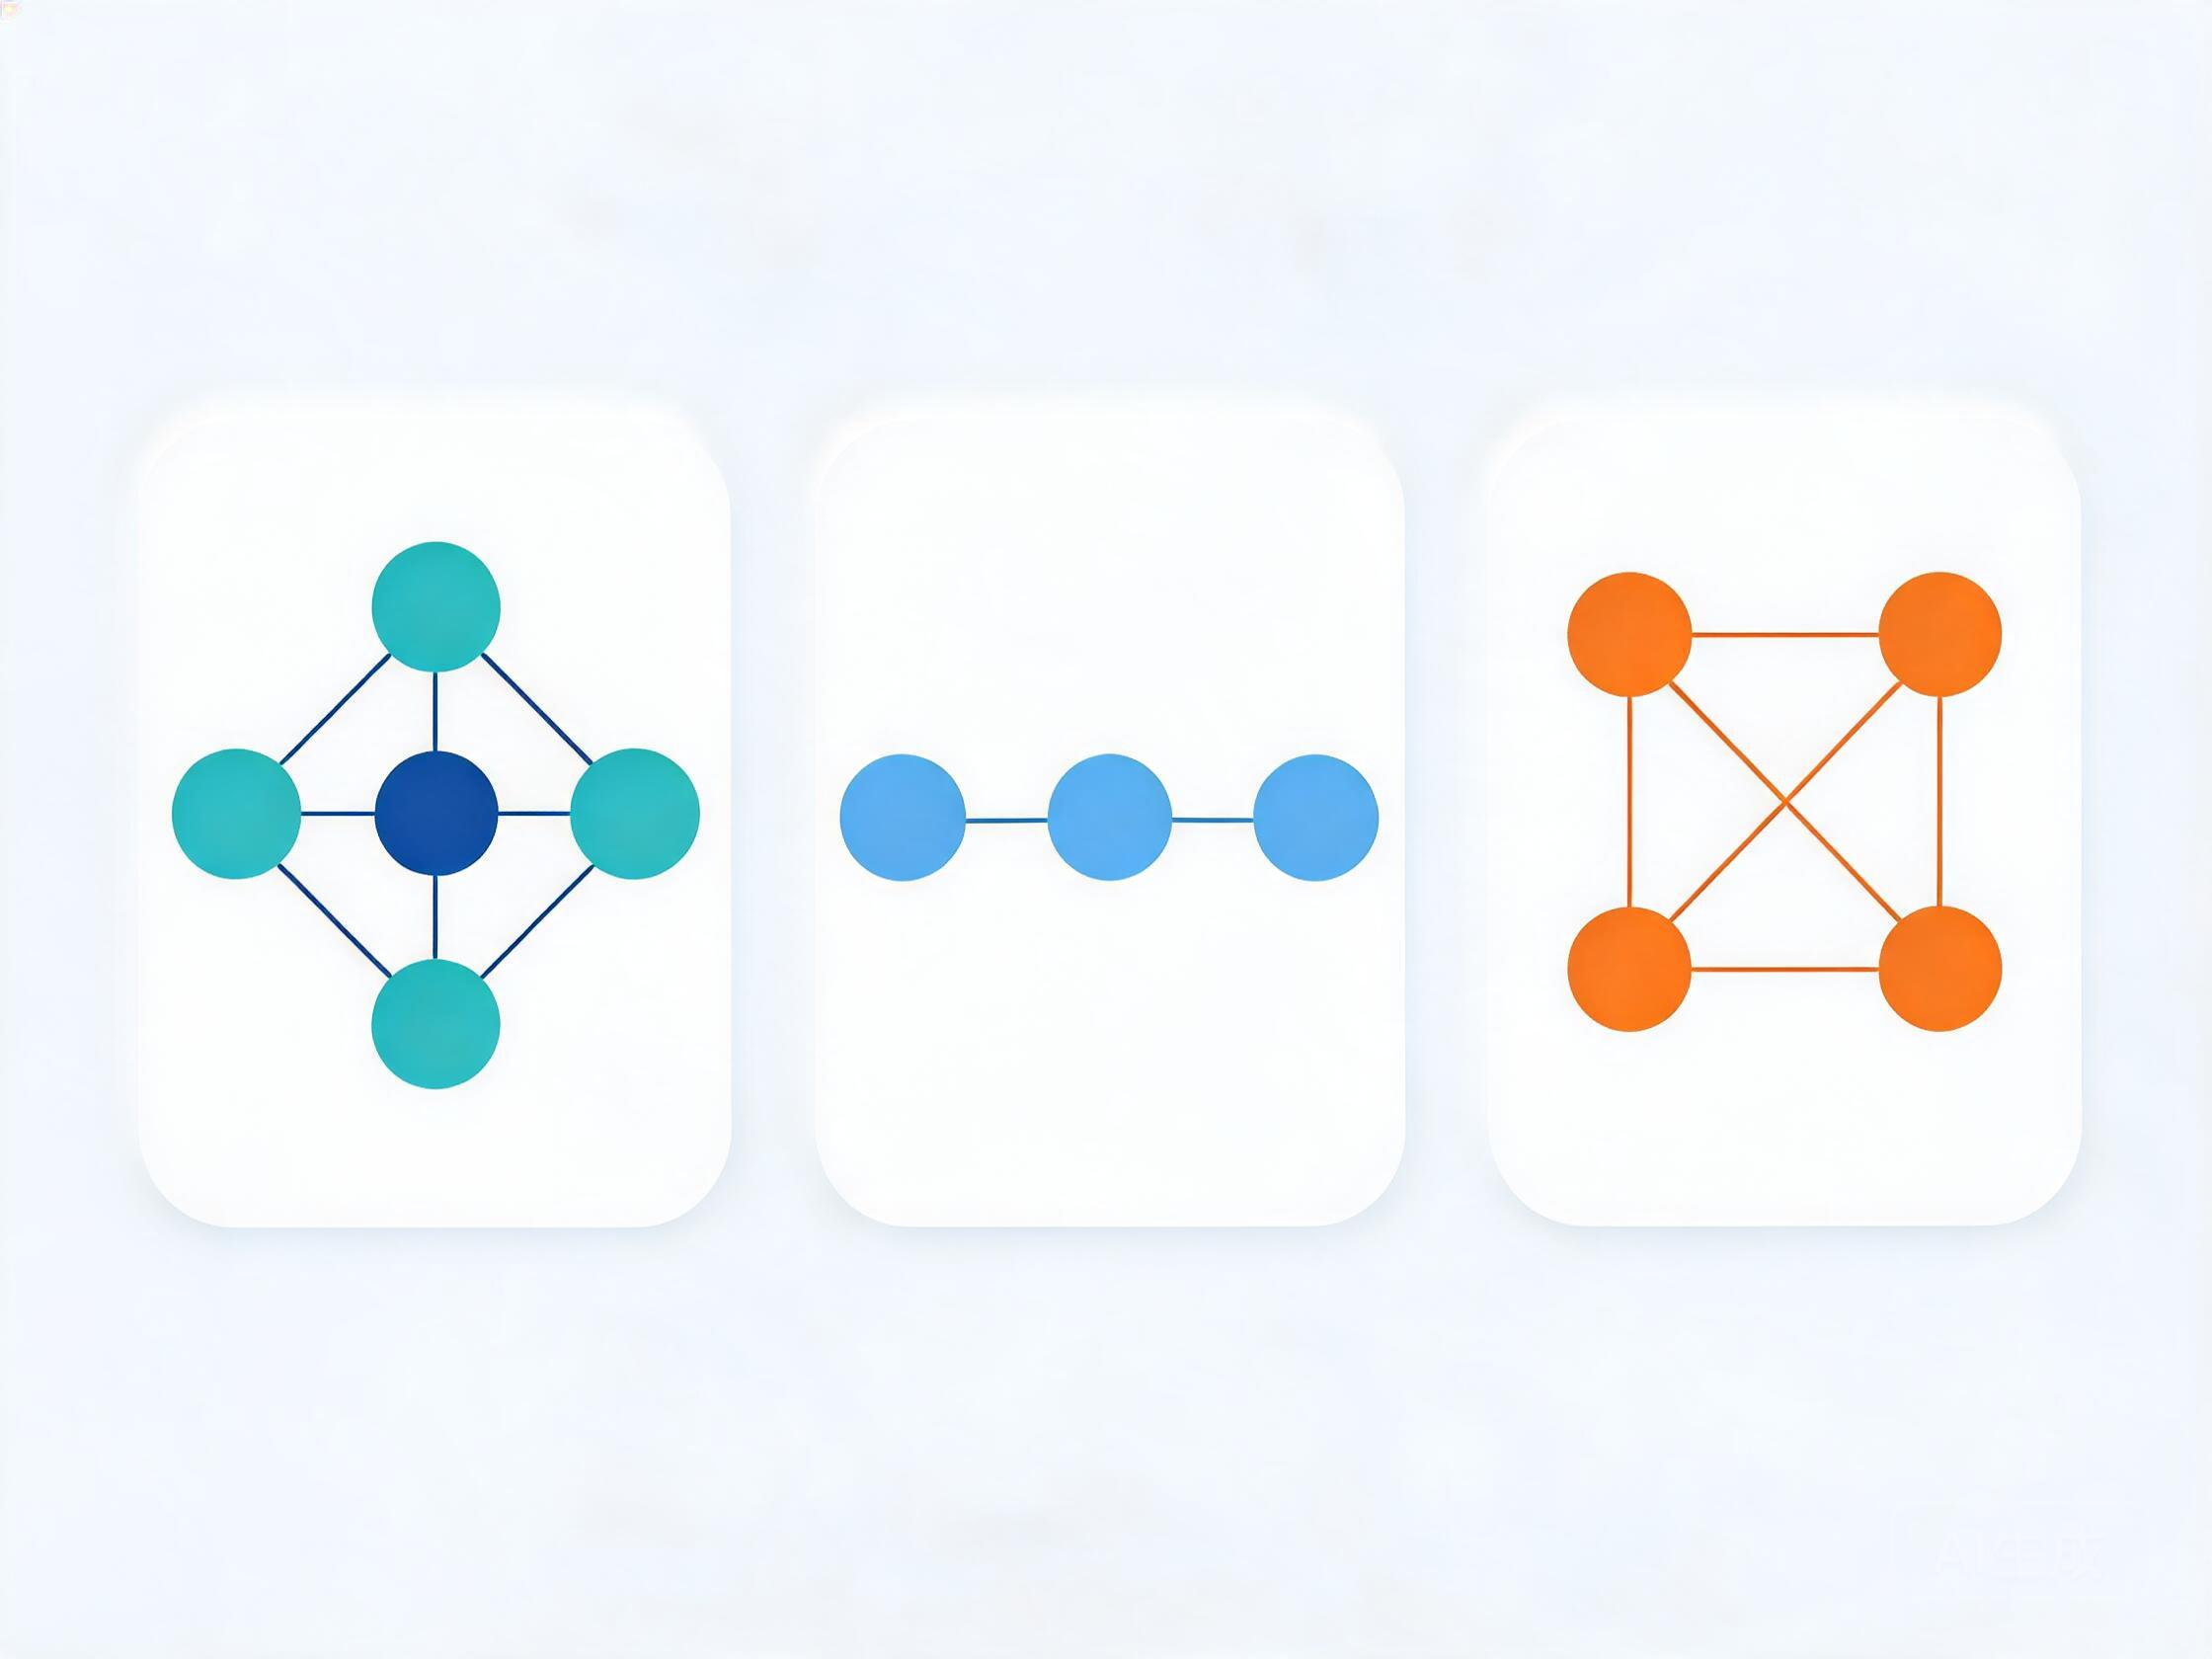
主管—工人:一个调度中心分发任务
结构上像一个中心节点加若干个执行节点。中心智能体负责理解任务、拆成子任务、分派下去,再把结果汇总成一份完整输出。
def orchestrate(task, max_steps=12):
    plan = planner(task)                        # 拆成子任务队列
    for _ in range(max_steps):                  # 步数上限,防跑飞
        step = plan.next()
        if step is None:                        # 队列空了就收工
            break
        agent = ROUTE[step.role]                # 按角色路由到对应智能体
        result = agent.run(step, memory=SHARED) # 只传这一步需要的上下文
        SHARED.write(step.id, result)           # 结果落到共享状态
        if result.failed:
            plan.replan(step)                   # 失败就重新规划,而不是硬重试
    return summarizer.run(SHARED)
这段伪代码里有三个设计点值得留意:步数上限、按角色路由、失败走重规划。它们分别对应后面要讲的三个失败模式。
这个拓扑适合"任务可拆分、结果需汇总"的场景,比如一份调研报告——检索、分析、撰写、校对各自独立,由中心统一收口。它的短板是中心节点容易成为瓶颈,任务一多,调度本身就成了负担。
流水线:按工序串起来
把智能体排成一列,上一步的输出就是下一步的输入。办公场景里比较典型的就是内容生产:草稿 → 事实核查 → 改写润色 → 格式规范。
它的好处是结构清晰、每一步的输入输出都能落盘留痕,出问题好定位。代价是错误会顺着管道往下走。前面把数字抄错了,后面的核查环节如果没查出来,错误就会被润色得越来越顺、越来越像真的。所以流水线里通常要特意插入一个独立的事实核查节点,它的职责就是唱反调。
群聊辩论:多个角色互相挑错
让多个智能体都看到同一个问题,各自给出答案,再互相评审、多轮修正。结构上接近全连接,任何两个节点之间都能对话。
这种拓扑在需要多视角校验的任务上有效,比如方案评估——让"成本视角""风险视角""用户视角"三个智能体各自挑刺,比单个智能体自问自答更容易发现盲区。
但它也是比较容易失控的一种。节点两两对话,轮次一多,token 消耗是随轮次平方级往上走的;而且各方的意见经常来回推翻,很难自然收敛。开篇那场拉锯,本质上就是群聊拓扑缺了收敛条件。
几种拓扑放在一起比
| 拓扑 | 结构 | 适用场景 | 主要代价 |
|---|---|---|---|
| 主管—工人 | 中心调度,多个执行者 | 任务可拆分、需要统一汇总 | 中心节点易成瓶颈 |
| 流水线 | 线性串接,前一步喂后一步 | 工序明确的内容生产 | 错误顺流放大 |
| 群聊辩论 | 全连接,多轮互评 | 需要多视角交叉验证 | 消耗高、难收敛 |
| 黑板模式 | 共享状态区,各自读写 | 长周期、多轮迭代的任务 | 状态管理复杂 |
通信机制:消息传递还是共享黑板
拓扑定的是"谁能跟谁说话",通信机制定的是"话怎么说、放在哪"。
消息传递是显式的:A 把一段结构化结果发给 B,B 收到后处理。优点是链路清晰,每一步都能打日志、能重放。缺点是上下文要么传多了浪费,要么传少了不够用,分寸不好拿捏。
共享黑板是隐式的:所有智能体读写同一块状态区,谁需要什么自己去取。它省去了点对点的传递成本,适合迭代周期长的任务,但状态一旦被并发写入,排查起来会相当麻烦。
实践中的折中做法是:用共享状态存全量产物,用结构化的消息做显式交接。智能体之间传递的不是整段对话历史,而是一个结构体——任务描述、上游结论、需要产出的字段。
# 结构化交接,而不是把整段对话粘过去
handoff = {
    "task": "汇总华东区Q3销售情况",
    "inputs": {"data_ref": "shared://step_3/result"},  # 用引用,不传全量
    "expected": ["结论", "数据来源", "存疑项"],
    "trace_id": "job_2026093001",
}
这里有几个细节很关键:inputs 里存的是引用而不是全量内容,避免上下文被撑爆;expected 明确列出要产出的字段,相当于一份交接契约;trace_id 贯穿全程,方便把一次任务的完整轨迹串起来回看。
五个常见的翻车点
| 现象 | 可能原因 | 处理方式 |
|---|---|---|
| 来回拉锯不收敛 | 没有终止条件,双方无限互评 | 设步数上限,加收敛判定(连续两轮结论一致就停) |
| token 账单失控 | 每步都把完整历史传给每个智能体 | 结构化交接,用引用代替全量粘贴 |
| 角色漂移 | 职责边界描述模糊,写作的干起了审核 | 每个智能体明确输入输出契约 |
| 错误顺流传播 | 上游结论没人校验就被下游采信 | 插入独立核查节点,关键结论交叉验证 |
| 出问题查不到原因 | 交互链路无记录,无法复现 | 每步落日志,trace_id 贯穿全流程 |
什么时候才真的需要多智能体
把上面这些看下来,会发现多智能体的收益不在"人多力量大",而在于把职责切干净。如果一个任务用单智能体加一段清晰的提示词就能稳定完成,拆成三个智能体只会多出协调成本、多出失败面。
判断标准可以简化成两条:任务能不能拆成职责互不重叠的子任务;子任务之间需不需要来回传递中间结果。两条都成立,多智能体才有意义。
至于选哪种拓扑,可以顺着场景倒推。任务能拆但需要统一收口,用主管—工人;工序本来就有先后,用流水线;需要多视角唱反调,才考虑群聊辩论。至于终止条件、上下文裁剪、trace 记录这些,无论选哪种拓扑都得配上——它们不是可选项,而是让系统能跑稳的底线。
