机器说话怎么越来越像真人了?聊聊语音合成从拼接走向端到端的技术迭代
有声书平台这两年有个挺明显的变化。早些年那些AI朗读的音频,一听就能听出来——语调平、断句怪,念到一半气息都不换。现在再点开某些平台的新书,同样是一段几百字的内容,停顿、重音、语气起伏都有了,不特意去分辨,很难听出那不是人录的。
这个变化不是某一次更新的功劳,是语音合成技术(TTS,Text To Speech)走了好几代的结果。每一代解决上一代的毛病,同时带出新的麻烦,一路迭代到现在。把这条脉络捋一遍,你会明白机器"说话"这件事,难点到底藏在哪里。
早期那批声音,是把录音剪开再拼起来
上世纪八九十年代的语音合成,思路很直接:请真人把各种音节、词、短语都录一遍,建成一个庞大的语音库。合成时,程序根据要读的文字,从库里挑出对应的片段,拼接起来,接缝处再做平滑处理。
这就是所谓的"拼接合成"。它的音质其实不差——因为每个片段都是真人录的,音色天然真实。但它有几个绕不过去的坎。
库有多大,能说的话才有多少。遇到库里没收录的词,尤其是不常见的专有名词、人名,合成结果就变得别扭。想让声音自然,就得不断增加录音量,一个发音人录几十小时是常事,成本高得吓人。
接缝问题是另一个硬伤。相邻片段拼在一起,频率、相位对不齐,听感上会出现细碎的杂音和跳变。而且它的语调基本是平的,因为程序只关心"把音拼对",不太管"这句话该用什么情绪"。这也是为什么当年的机器声音总有种念说明书的既视感。
统计参数合成带来了灵活性,也丢掉了音质
到了二十一世纪前十年,主流方案换成了"统计参数合成"。它的核心变化是不再用录音片段拼接,而是用模型去"预测"声音应该长什么样。
流程大致是这样:把语音信号分解成几类参数——描述声道的频谱参数、描述音高的基频参数、描述节奏的时长参数。然后训练一个模型,学会从输入文字预测出这些参数。合成时,模型先算出参数,再由一个叫"声码器"的模块,把参数还原成波形。
这一步的价值在于灵活性。模型可以从文字里学到韵律规律,遇到不同的句子,能自己决定哪里该停顿、哪个字该重读。文件体积也小,不需要几十小时的录音,一个模型文件就能描述一个发音人的特征。
代价出在音质上。参数是高度压缩过的,一旦压缩,原始语音里那些细微的质感就被抹平了。还原出来的声音干净是干净,但带着一种挥不去的电子味、金属感,也就是大家常说的"机器人腔"。参数化程度越高,声音越平滑,也越不像人。
神经网络入场后,参数开始由网络自己学
深度学习普及之后,这一套玩法被推翻重来。模型不再依赖人工设计的那几类参数,而是让神经网络直接从文字映射到声音特征,中间表示长什么样、包含哪些维度,全由网络自己学出来。
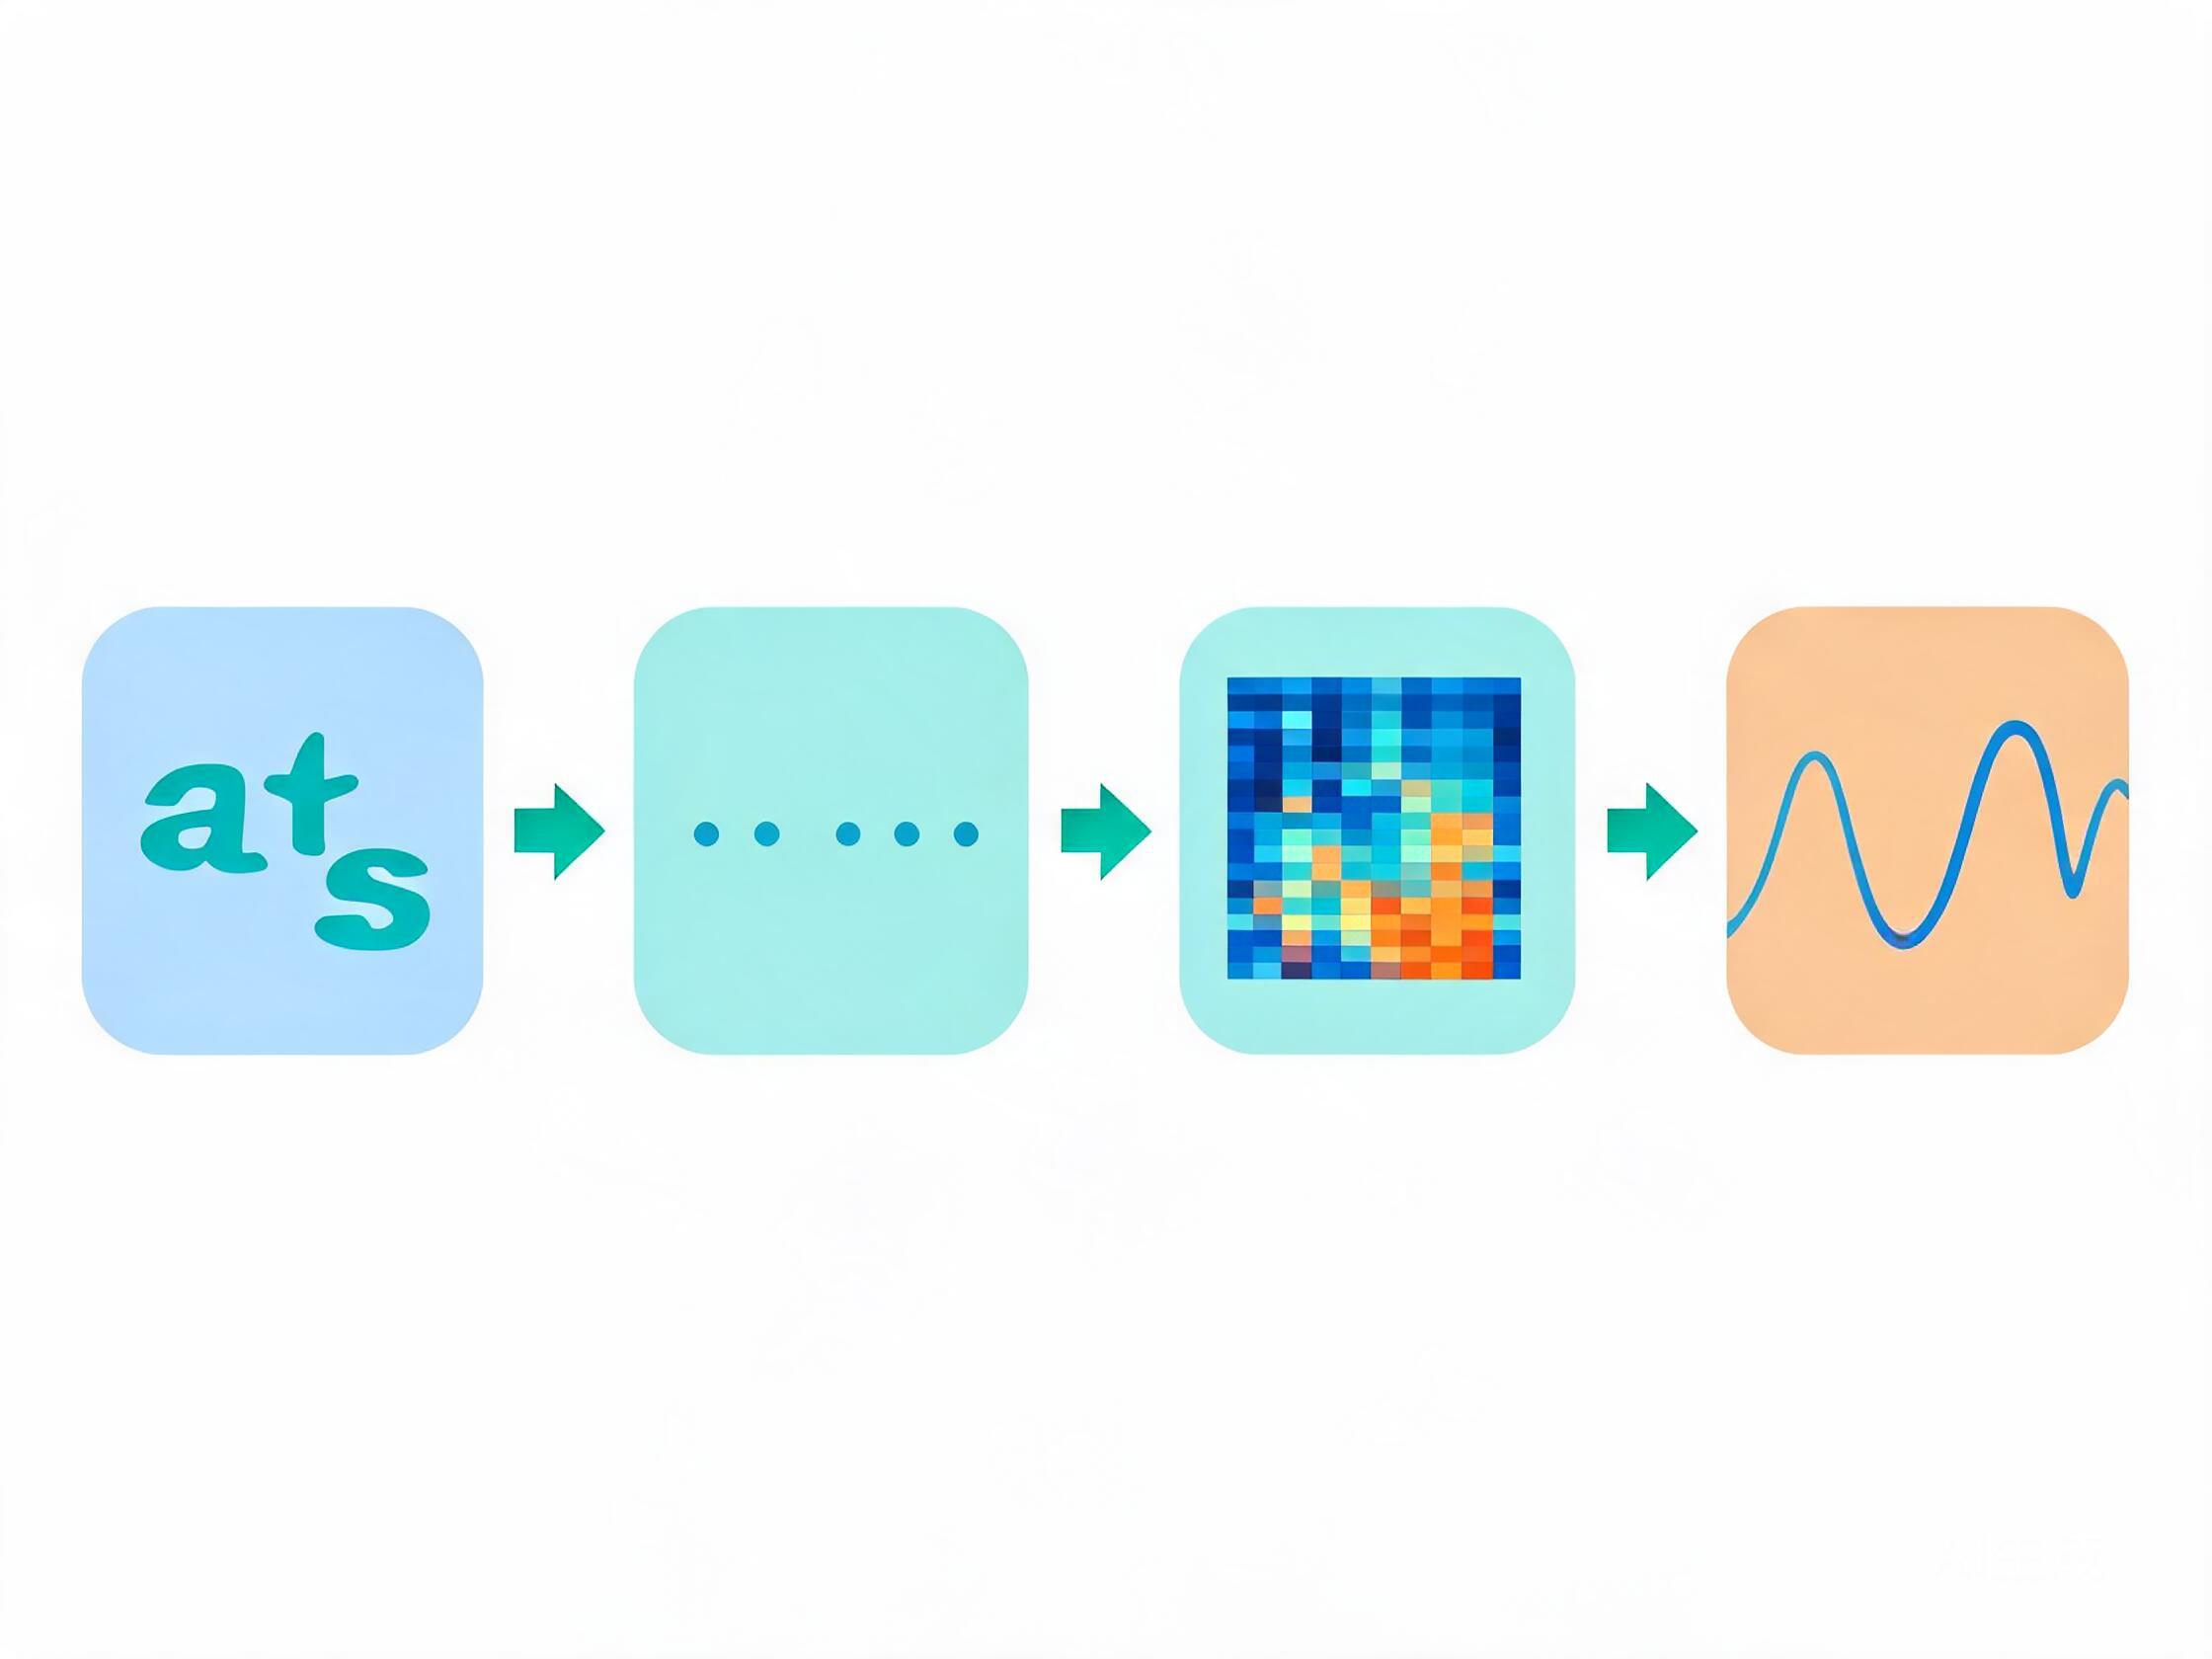
这个阶段的标志性概念叫"声学模型"。文字先被转成音素序列(把"你好"拆成具体发音单位),再喂进声学模型,输出一张叫"梅尔频谱"的图。
梅尔频谱可以理解成声音的"照片"——横轴是时间,纵轴是频率,每个点的颜色深浅代表那个时间、那个频率上的能量强弱。它记录的是声音的频谱特征,还不是能直接播放的波形。
把频谱变成波形这件事,交给"声码器"完成。这是整个流程里对音质影响相当大的一环。早年的声码器还原能力有限,频谱里明明有细节,输出却总是发闷、发虚。后来出现的WaveNet以及一系列基于神经网络的声码器,把这一步的还原度拉高了一大截,声音的颗粒感、气声、齿音这些细节慢慢回来了。
端到端把中间环节也吃掉了
再往后走,连"文字→音素→频谱→波形"这种分步走的做法也被简化了。新一代的模型尝试把整条链路压进一个网络:输入文字,直接输出波形,或者只保留一个很精简的中间表示。这类做法统称"端到端语音合成"。
端到端的好处是少了中间环节的误差累积。传统流程里,每一环都会丢失一点信息,音素转错一点、频谱预测偏一点,到波形那一步就放大成了可听的瑕疵。端到端让模型整体优化,误差不会层层叠加。
它还带来一个附带能力:音色和风格可以被"解耦"。模型能把"说了什么"和"谁在说、什么语气"拆成两件事。于是出现了声音克隆、情感语音、跨语言合成这些玩法——拿几秒钟的样音,让模型学会一个人的音色,再套到任意文字上。
这项能力是把双刃剑。前面网站聊过声音克隆被用来诈骗的案例,技术本身没有对错,问题出在使用它的人。眼下平台和监管都在往"合成语音需要标识"这个方向推,算是给这项能力装上一道提醒。
把这条技术路径捋一遍,从"剪录音拼起来"到"让网络自己学",走的其实就是一条不断减少人工干预、把更多细节交给数据去决定的路。机器说话越来越像真人,不是因为某个环节被攻克了,而是整条链路上,每一处不自然的地方都被后来者一点点磨平了。
回过头看,有声书那个变化,是这条迭代链条终于走到了"以假乱真"的门口。至于门后面还有什么,大概用不了几年就又会有新答案。
