AI 视频角色总变脸?角色一致性与首尾帧控制技巧
用 AI 做视频,真正劝退的不是"不像",而是"上一秒还是这个人,下一秒脸就换了"。一条几分钟的短剧,主角在镜头间来回变脸,再好的画面也救不回来。
这背后是文生视频的一个通病:每一段独立生成,模型之间没有"这是同一个人"的记忆。要解决,就得靠两件工具——角色一致性控制,和首尾帧控制。这篇拆痛点、给解法。
痛点一:每段独立生成,角色没记忆
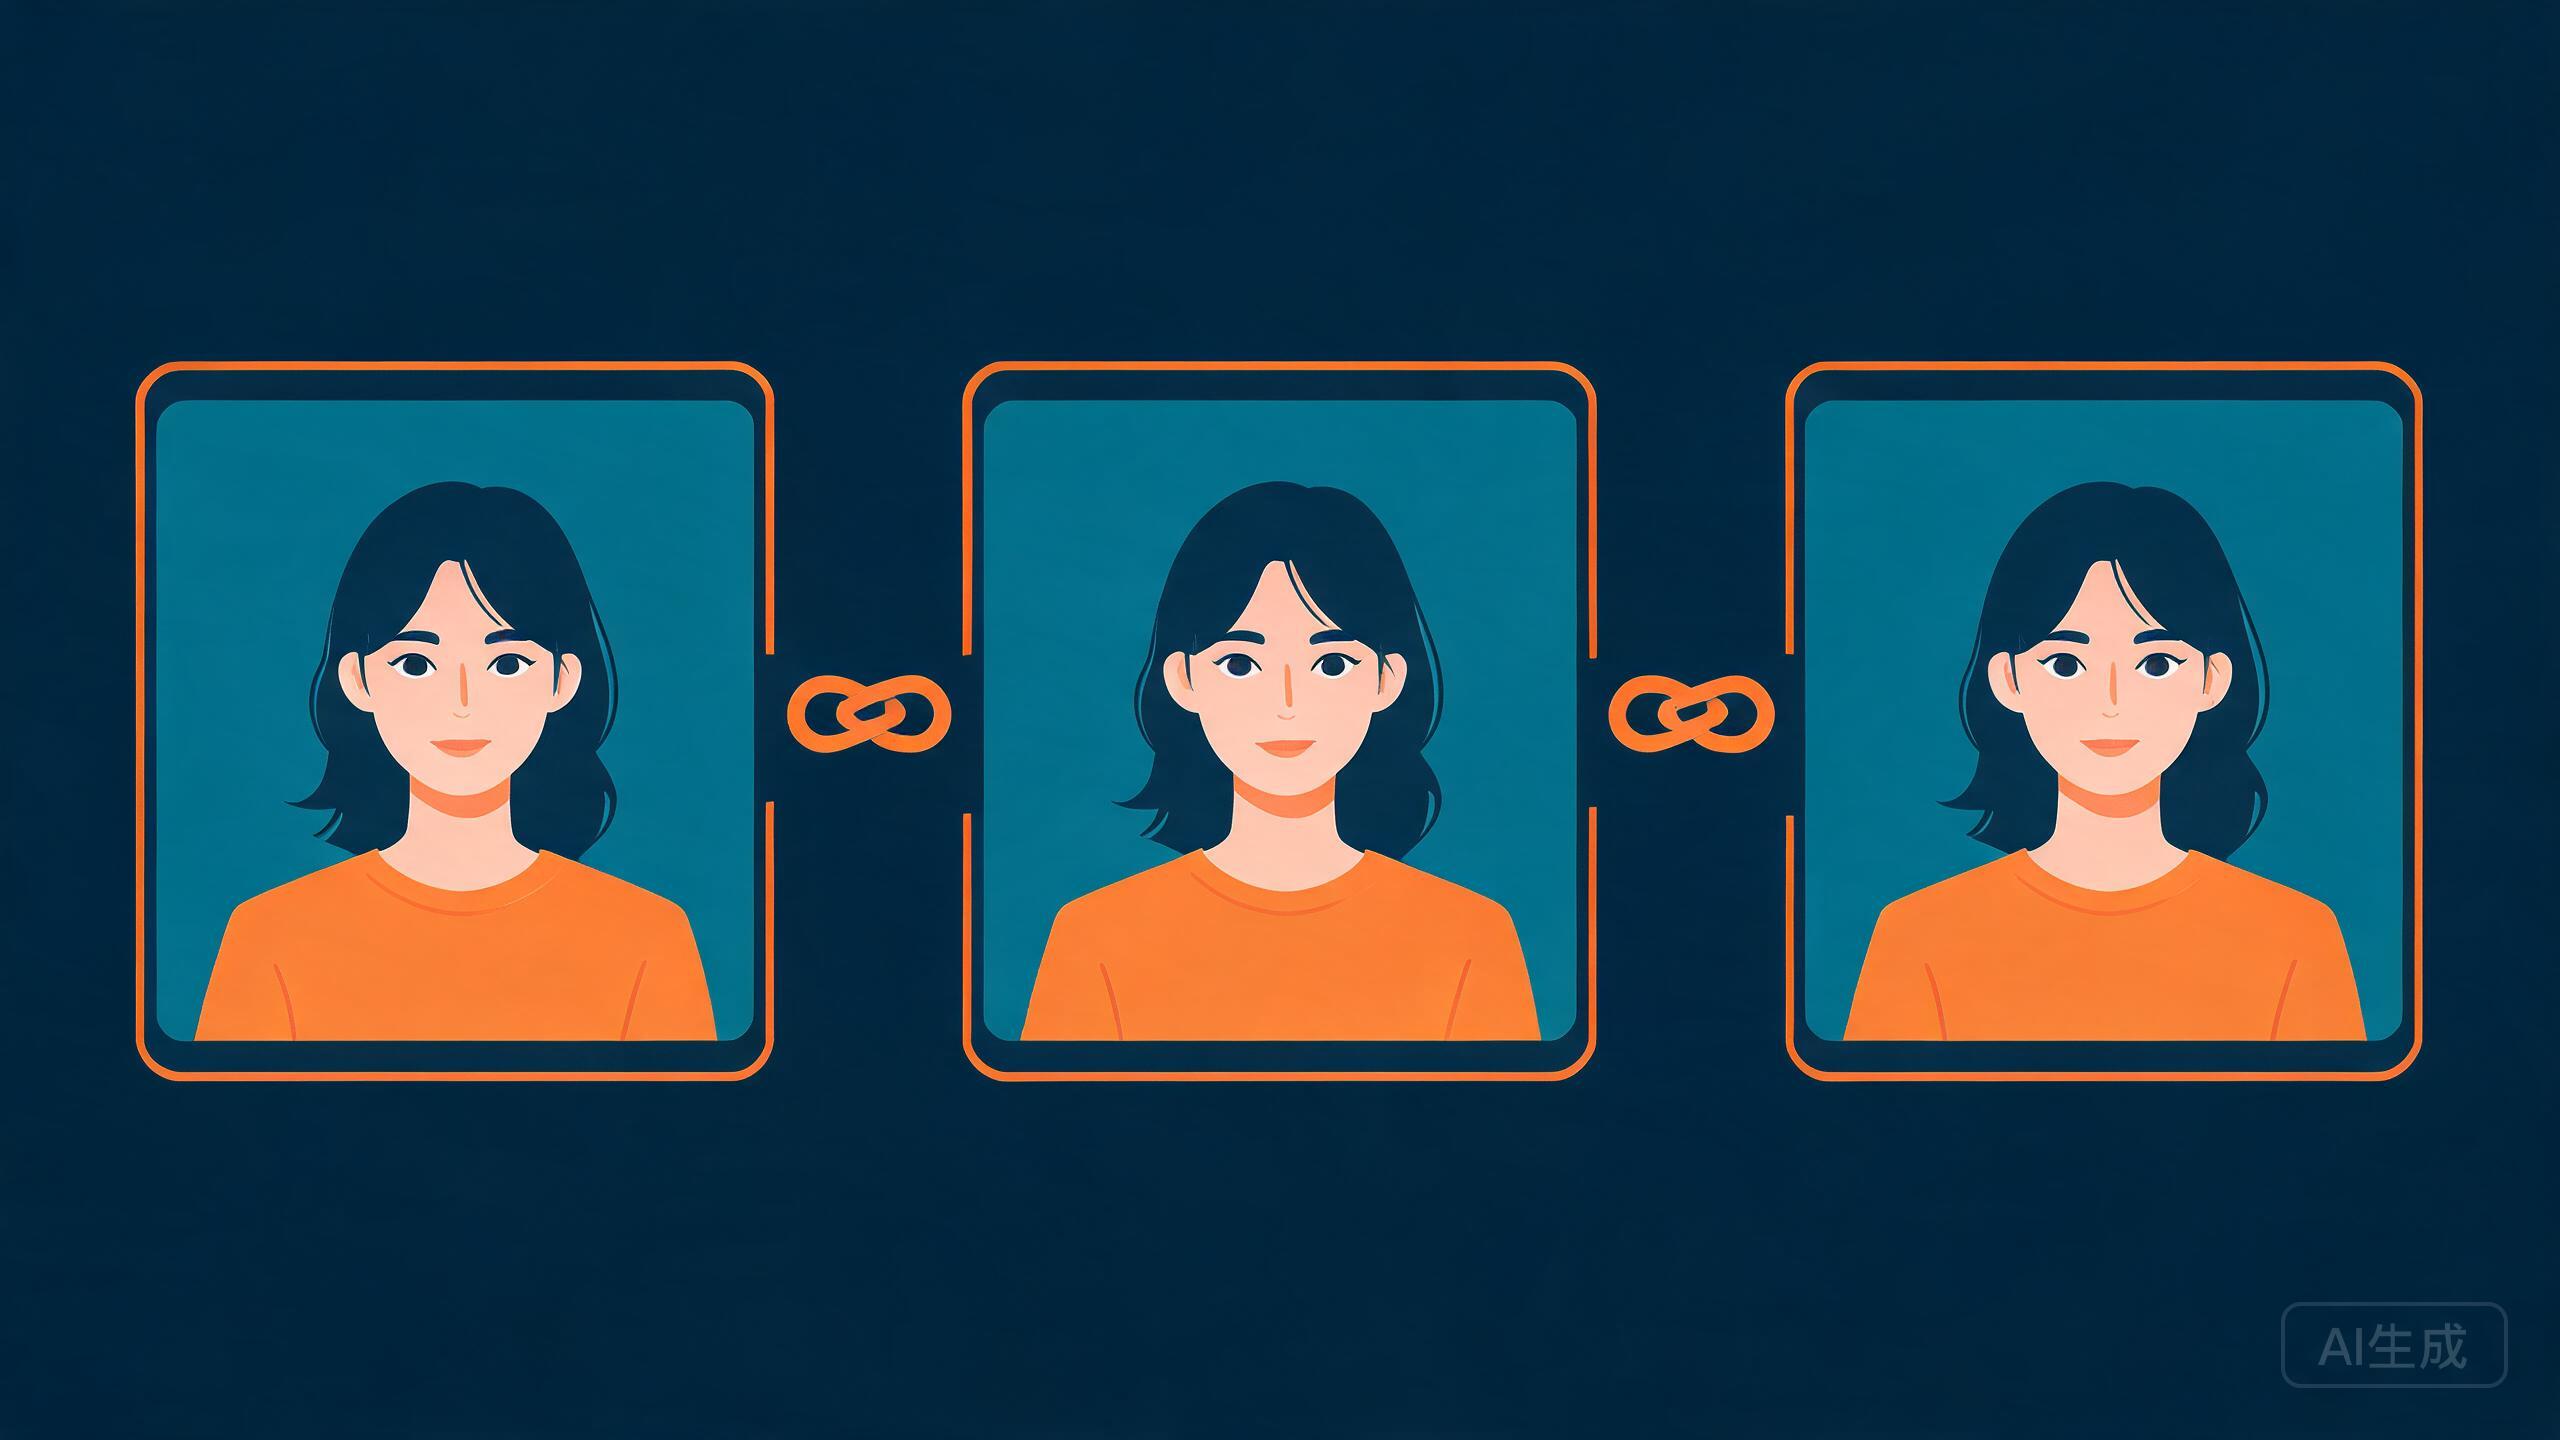
根子先说清楚:现在大多数视频工具,是"喂一次提示词、出一小段视频",段和段之间不共享记忆。哪怕两段提示词都写"一个短发女生",模型也可能画出两个不同的人。
所以着手点不是"把提示词写得更细",而是先想办法给角色一个"固定参照",让每段都照着它来。
解法:角色参考图 + 锁定主体描述。先花一张图,把角色的脸、发型、衣服定成一张参考图;之后每段生成都挂上这张参考图,同时把提示词里的主体描述固定成同一句话,别换来换去。"短发女生"改成"黑色波波头、左眉有颗小痣、穿米色高领毛衣的女生",词和图两头锁死,跨段变脸的概率就压下去一大截。
痛点二:文生视频难控,图生视频更稳
直接文生视频,等于让模型同时"编角色"和"编动作",两个变量一起飘。把角色先固定成图,再让视频从这张图出发,变量少一个,稳一档。
解法:先图后视频,把角色"钉"进首帧。先出一张满意的角色图,再用图生视频功能,拿它当起始帧生成动作。这样开头那一刻的长相、衣着已是确定的,模型要做的只是"让这个确定的人动起来",比凭空生成可控得多。凡是追求角色连戏的片子,图生视频是比文生视频更稳的那条路。
痛点三:动作幅度失控,人物会崩坏
角色变脸的另一个高发时刻,是动作一大就崩。模型在生成大幅运动时,为了"补"中间过程,常把手、脸、肢体画走样。
解法:控制运动幅度 + 缩短单段时长。提示词里写清"轻微"“缓慢""保持上半身稳定"这类约束,少写"奔跑、翻滚、打斗"这种剧烈动作;单段控制在几秒内,让模型只补一小段连贯动作。动作越收敛,脸部越不容易崩。
痛点四:开头结尾对不上,镜头接不住
做多镜头拼接时,常出现前一个镜头的结尾姿势,和下一个镜头的开头姿势完全对不上,剪辑点就露馅。
解法:用首尾帧控制,把"起点"和"终点"都指定。不少工具支持同时指定首帧和尾帧:给模型一张"从这里开始"的图和一张"到这里结束"的图,让它补出中间那段连贯过渡。比如一个"转身"镜头,首帧是正脸、尾帧是侧脸,中间动作就顺着过渡过去,跨镜头的接缝自然很多。
痛点五:多镜头切换,风格忽亮忽暗
除了角色,色调、亮度、画风在镜头间跳变也很扎眼。一段暖黄一段冷青,观众立刻出戏。
解法:统一风格前缀 + 固定参数。把风格描述写成一段固定的前缀,每个镜头原样带上:"35mm 胶片、浅景深、暖金日落、颗粒感中等"。色调、光线、画幅这些能锁的参数尽量锁死,宁可牺牲一点单镜头的发挥,也要保住整片的统一。
实操顺序:把"控"字做在前头
把这些技巧串成一条可复用的流程,逻辑是"先定角色、再定动作、后拼镜头":
先用一张图定下角色的脸和衣着,做成参考图。
再写一段固定的主体描述 + 风格前缀,复用到底。
需要角色动,就走图生视频;需要跨镜头衔接,就上首尾帧。
单段保持短,动作保持克制;收尾靠剪辑把成段拼起来。
这四步不是死规矩,而是一条让"随机生成"尽可能变成"可控生产"的次序。先控角色,再控动作,收尾控节奏,翻车点就一个接一个被关掉了。
小结
把角色一致性收一收:变脸的根子是段与段之间没有记忆,解法是参考图固定长相、主体描述锁定措辞,再优先走图生视频、用首尾帧控制跨镜头衔接,动作和单段时长都往回收一收,风格参数全程统一。
AI 做视频的差别,往往不在你会不会写酷炫的提示词,而在你肯不肯把"控制"这件事做在前面。角色稳住了,片子才有资格谈好看。
