一张照片怎么动起来?图生视频的原理拆解(图片转视频技术解析)
这两年短视频平台流行一种"复活老照片"的玩法:上传一张泛黄的旧照,人物会眨眼、转头、微微一笑,仿佛被赋予了生命。这类效果的背后,是图生视频(Image-to-Video)技术——把一张静态图片作为起点,让模型在它之上"续"出一段合理运动的视频。
它和文生视频像,又不完全是一回事。文生视频从一段纯文本描述凭空起稿,图生视频则多了一个强得多的约束:那张输入图不能变。怎么既守住这张图、又长出自然的运动,是它的全部技术难点。这篇把这两件事拆开讲。
图生视频多了什么:一张不能动的主心骨
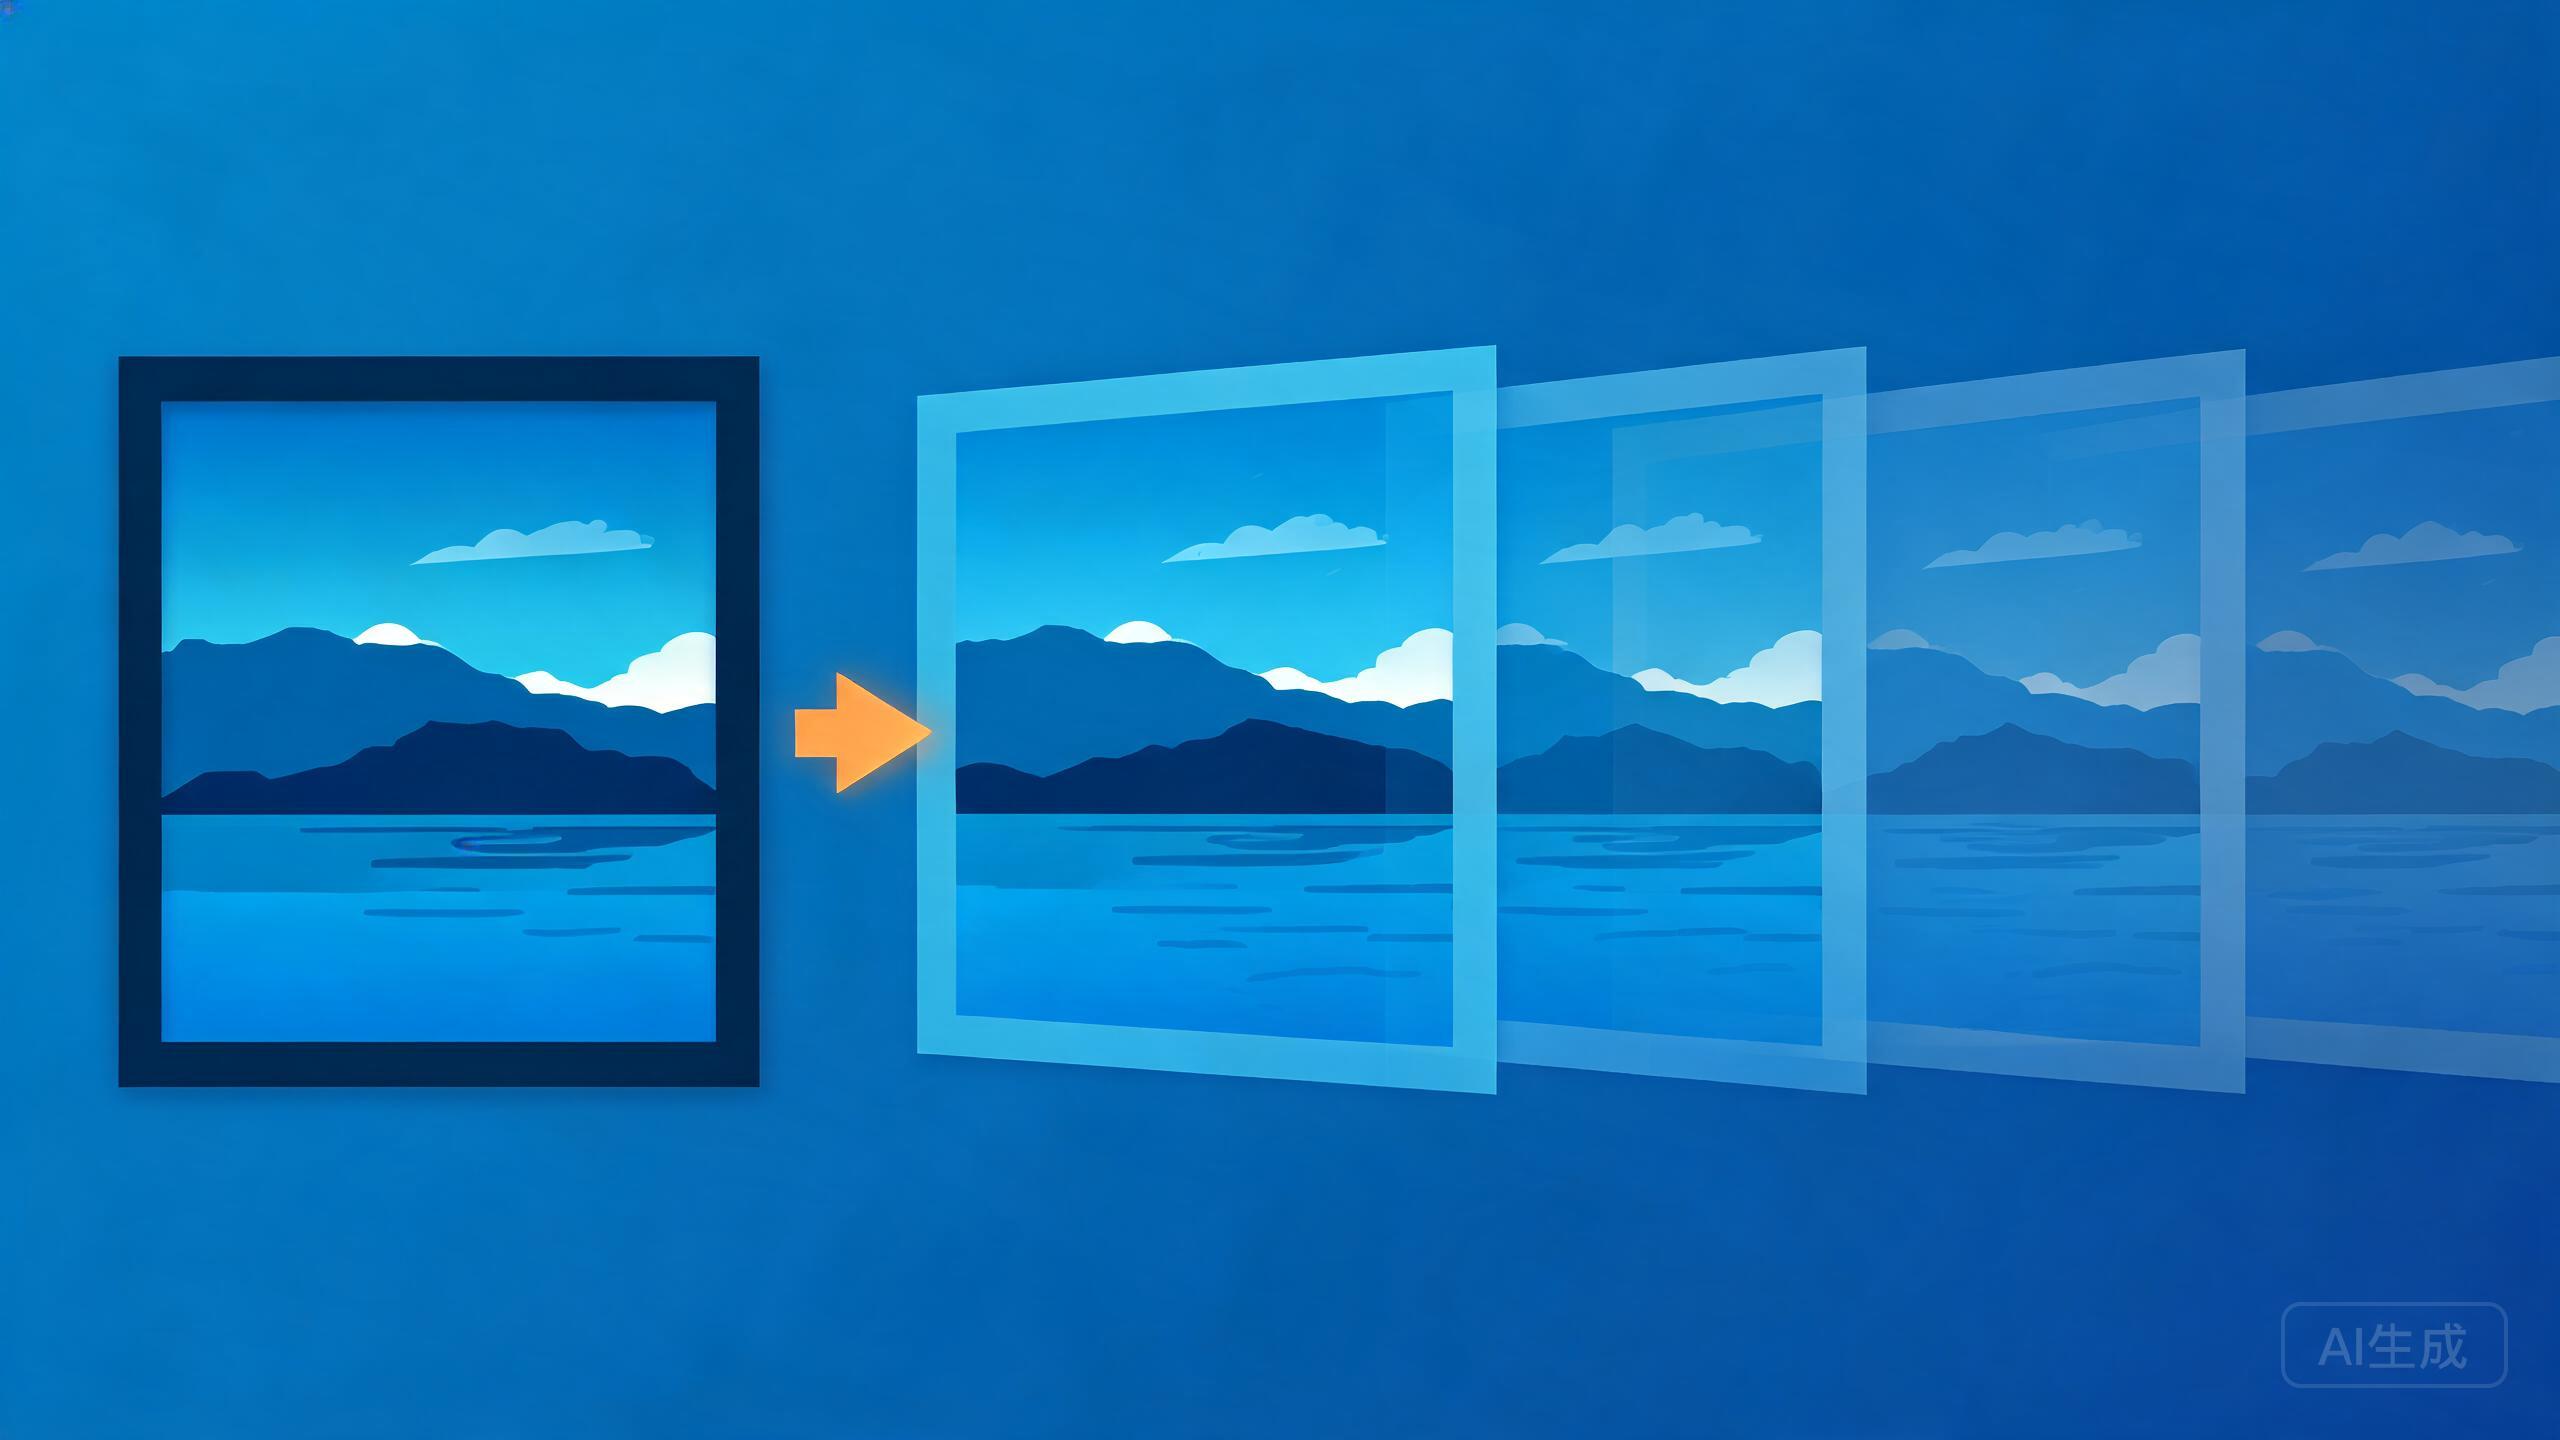
文生视频的输入是一句提示词,模型有很大的自由去决定画面里有什么、长什么样。图生视频的输入多了一张具体的图,它既是"画面内容的来源",又是"必须保持的结果"。这个差别,把问题性质都变了。
从生成的角度看,那张图扮演的是"起始帧"的角色。视频不是凭空开始的一连串画面,而是从这张特定的图出发,往后延伸出若干帧。这意味着输入图上的每一个人、每一处细节、每一缕光影,都得在后面的帧里保持一致,不能画着画着就换了张脸、改了片天。
所以图生视频的技术骨架,可以概括成两条主轴:一条负责"守住起始帧",另一条负责"长出运动"。两条线得同时成立,视频才像样。
主轴一:把起始帧"焊"进生成过程
怎么让模型别把那张图忘了?比较直接的手段,是把起始帧当作一个显式的条件,注进扩散模型的每一步。
做法通常是这样的:先把输入图通过 VAE 编码到潜空间,得到一个潜变量;生成视频时,起始帧的潜变量就作为条件,和后面每一帧的生成过程对齐。模型在去噪的每一步都能"看到"起点长什么样,后续帧的潜变量就被约束在起点附近,不至于漂走。
更细的一层,是"帧与帧之间的潜变量要对得上"。如果后面每一帧都各自独立去噪,帧间就会出现之前讲时序一致性时说过的闪烁——这里不再展开,只强调一点:图生视频对帧间一致性要求更高,因为起点是实实在在的一张原图,任何一帧崩了,都能被观众一眼对照出来。
为了强化这种保持,模型通常还会在损失里强调"生成帧和起始帧的感知相似度",让画面在颜色、纹理、身份这些层面别跑偏。简单说,起始帧不是"看一眼就完",而是被反复拿来当尺子量后面的每一帧。
主轴二:运动从哪来,这是个真问题
守住了图,还得想清楚"怎么动"。一张静态照片里没有任何运动信息,模型凭什么知道人物该往哪边转头、水该往哪边流?
运动信息的来源,大致可以分两派。
一派是显式地估运动。先用光流这类方法,估计每个像素"该往哪边、动多少",拿到一张运动场,再让生成过程照着这个场去演化帧。这样运动是可控、可解释的,但光流本身估得不准,后续画面就跟着歪。
另一派是隐式地学运动。给模型加一些专门处理时间维度的模块(比如时序注意力),让它在大量视频数据里自己学会"合理运动长什么样"。这派不显式算光流,运动是模型从数据中学到的先验,表达更灵活,但可控性差一些,偶尔会冒出不符合物理的怪动作。
两派也常混着用:既给运动模块学先验,又用光流或骨骼点做约束。不同模型的做法不同,但落到根上都指向同一件事——运动不会从静止的图里无偿得到,必须有一个专门的机制去补充它。
图生视频典型的两类翻车
把上面两条主轴反过来看,恰好对应图生视频常见的问题。
起始帧没守住,表现是"漂移"——头几帧还好,越往后越走样,人物的脸渐渐不是原来那张,背景也悄悄变了。根子通常是从起始帧向后续帧传递约束时衰减了,越远越松。
运动没长好,表现是"僵硬或怪诞"——人物像贴纸一样平移两下,或者肢体以违反物理的方式扭动。根子是运动先验不够,或者运动场估错了地方。
所以评价一个图生视频模型好不好,往往就盯两个维度:画面保真度(跟原图像不像)和运动自然度(动得合不合理)。两个维度之间的拉扯,也解释了为什么有些作品"清晰但死板",有些"灵动但变形"。
小结
图生视频看起来只是文生视频"多给一张图",实则是加了一个强约束,把问题掰成了两条主轴:一条要反复把起始帧当作尺子,焊住画面不让漂;一条要额外补上运动信息,让静止的图活起来又不失物理合理。
理解这两条主轴,再看那些"复活老照片"的作品就有判断力了:好的结果是两条线都均衡,画面稳、动作自然;翻车的结果,多半是其中某一条线松了。技术还在往前走,但这套"守图—生运动"的框架,短期内依然是图生视频绕不开的底层结构。
