视频扩散模型为什么离不开3D VAE?潜空间压缩和DiT骨干的架构拆解
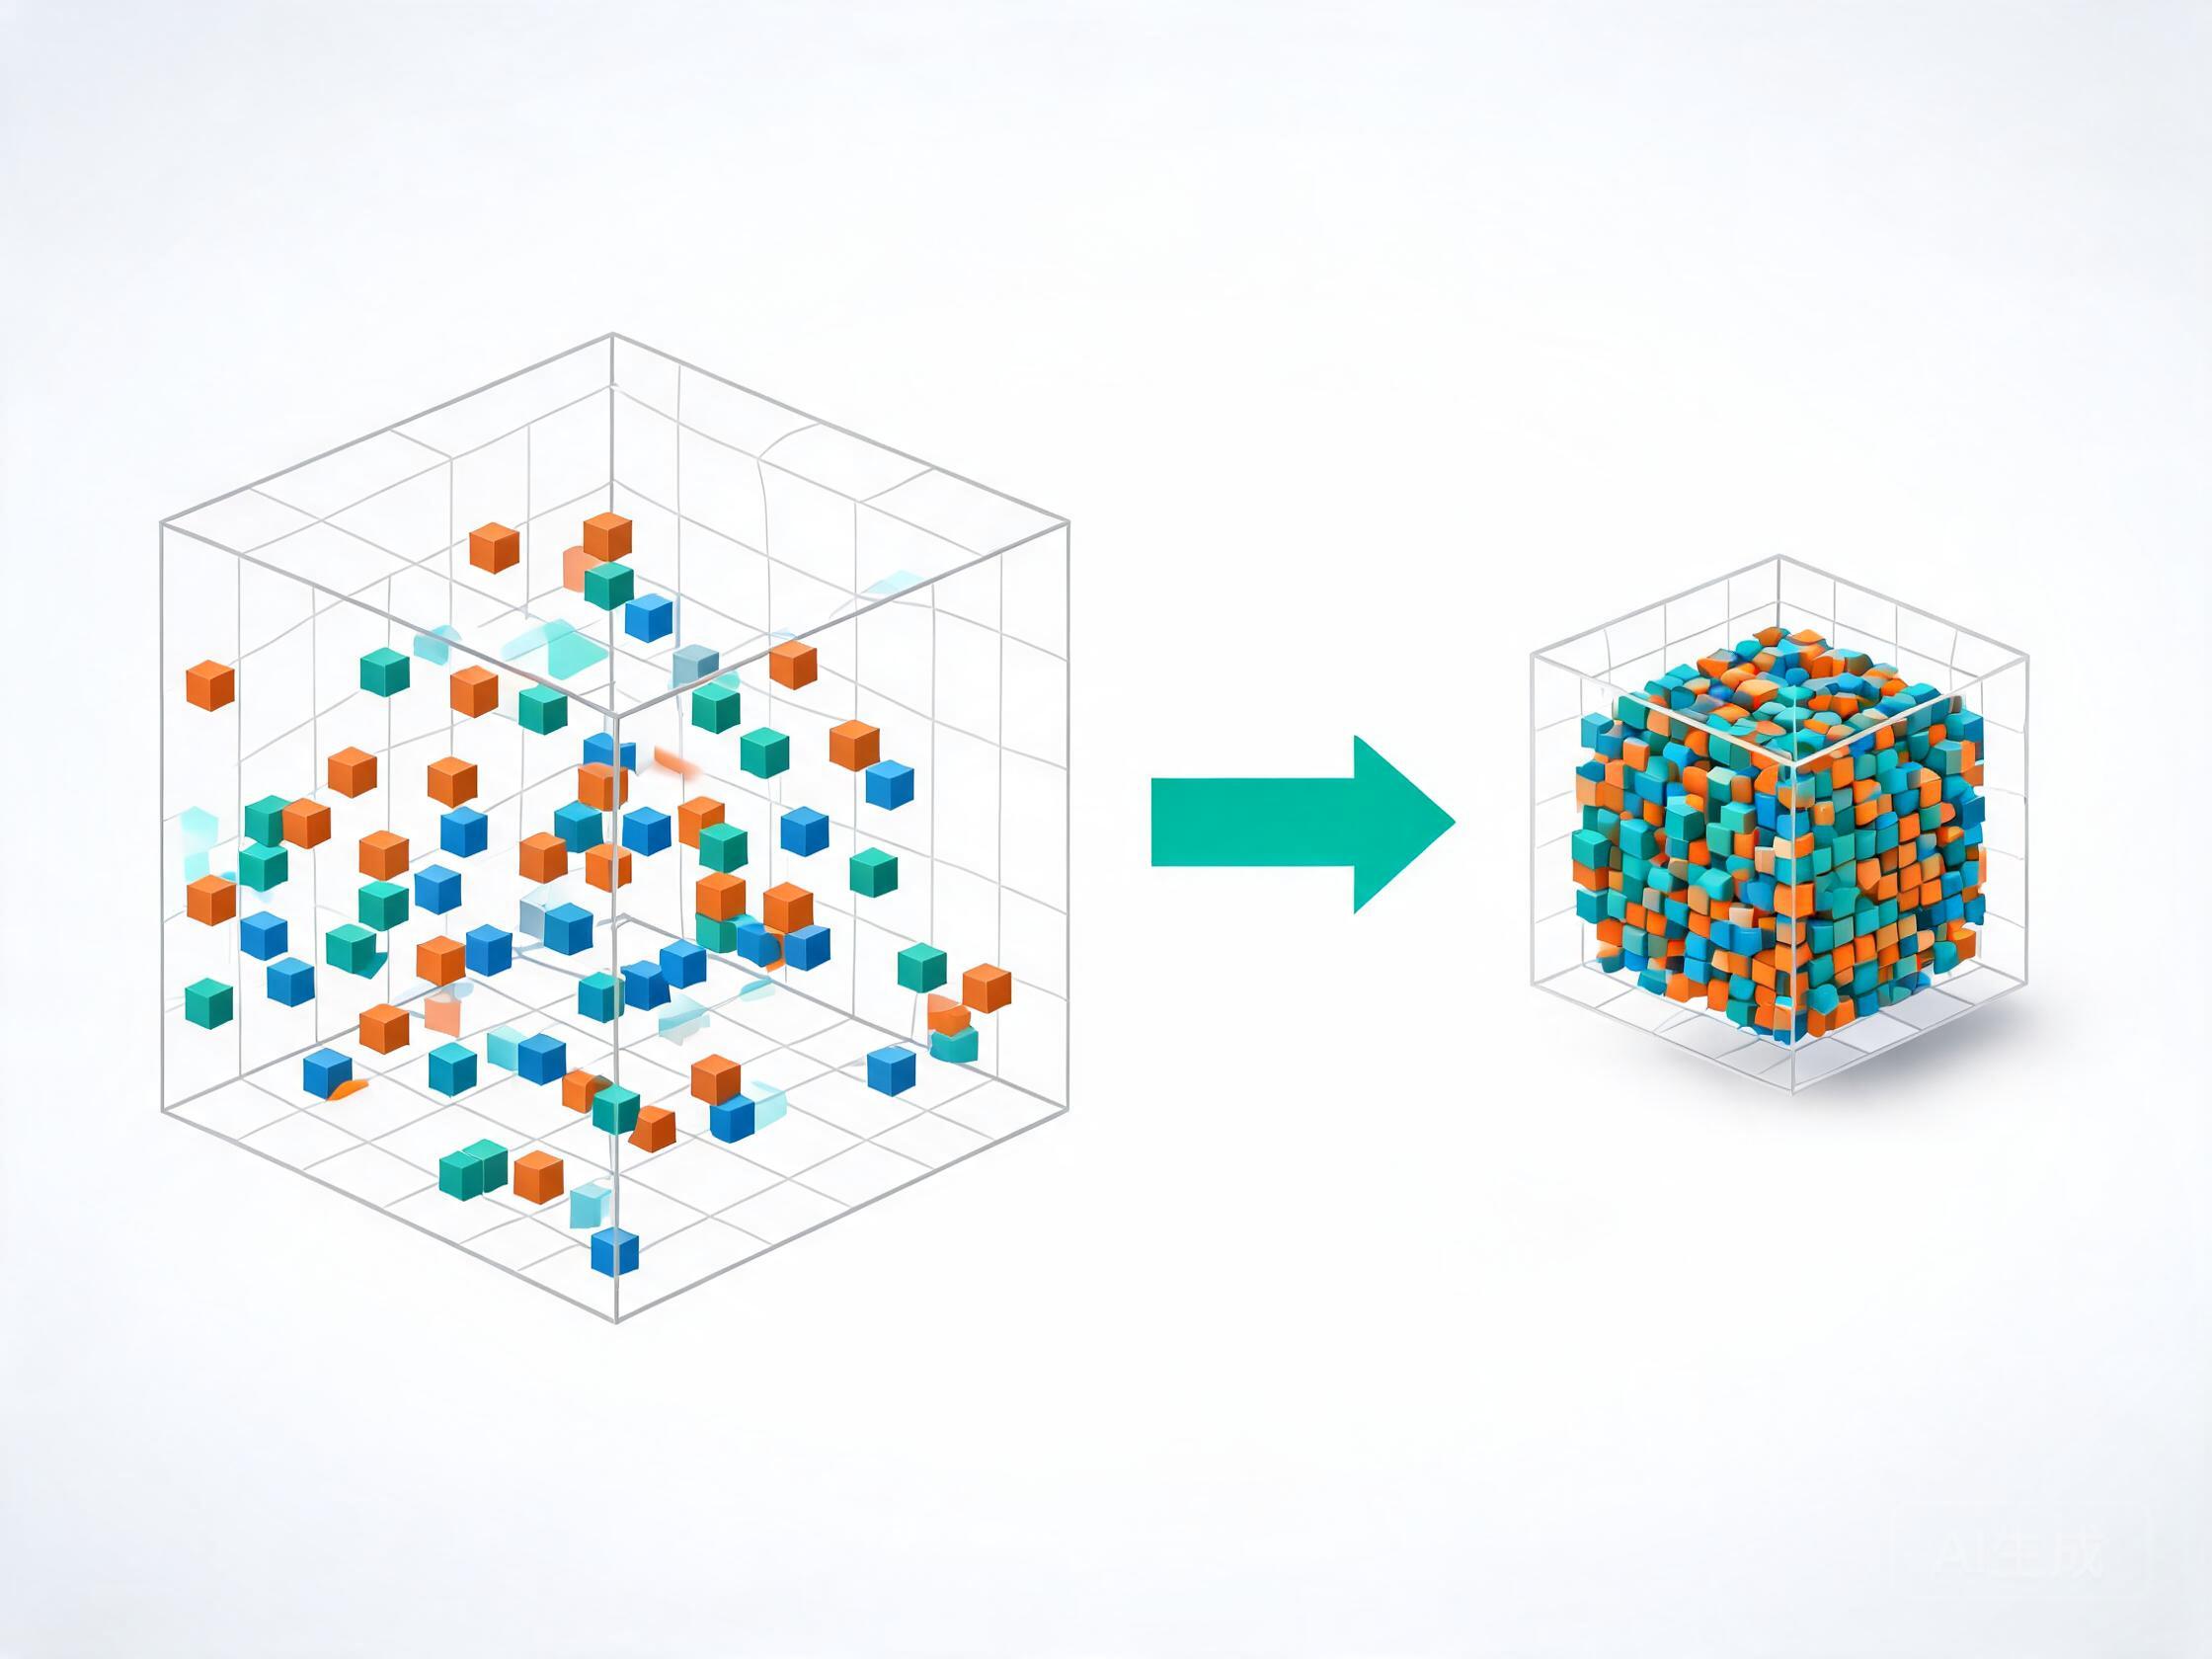
先抛一个数量级上的问题。如果直接在像素空间对视频做扩散,一段512×512分辨率、16帧的片段,按16×16的图像patch切分,序列长度是(512/16)×(512/16)×16=16384个token。这还只是16帧、低分辨率。把帧数提到128帧,token数直接破十万。扩散模型要在这种规模上跑几十步去噪,显存和算力都撑不住。
所以工业界的视频生成方案,基本都走了同一条路:先想办法把视频压缩到一个维度低得多的空间里,再在这个压缩后的空间做扩散。这条路上有两个关键件——负责压缩的3D VAE,和负责去噪的DiT骨干。这篇文章按数据流向,把这两层拆开说清楚。
为什么不直接在像素上做扩散
图像扩散模型(比如Stable Diffusion)已经把这个问题回答过一遍:像素空间冗余太大。一张自然图像里,相邻像素高度相关,直接建模等于重复计算大量冗余信息。它的做法是先用一个VAE把图像压到潜空间,潜空间的分辨率通常是原图的1/8,通道数放大到4,整体信息量降了一个量级,扩散过程在这个小空间里跑。
视频是图像的扩展,冗余只会更多。同一段视频里,相邻帧之间变化很小,像素级重复的比例比单张图还高。把图像的latent扩散方案直接搬到视频上,思路就是给VAE补上时间维。
3D VAE:把视频压进潜空间
处理视频的VAE叫3D VAE(也叫时空VAE、Video VAE)。跟图像VAE的差别在于,它的卷积核是三维的,除了高、宽两个空间维度,还多了一个时间维度。
压缩比例是两个维度一起下采样。空间上压缩8倍,时间上压缩4倍,是很常见的一组配置。举个数:一段512×512、16帧的视频,经3D VAE编码后,潜变量尺寸约为64×64×4(高、宽、时间),通道数为4。
| 表示 | 尺寸(H×W×T) | 说明 |
|---|---|---|
| 原始像素 | 512×512×16 | RGB三通道,信息冗余高 |
| 潜变量 | 64×64×4 | 空间8倍、时间4倍下采样 |
这里有个取舍。压缩率越高,后续扩散的计算量越小,但细节损失也越大,解码回来容易糊。压缩率低了,质量保住了,算力成本又上去了。所以不同的开源实现,VAE的压缩配置会不太一样,但整体思路都是空间多压、时间适度压——因为时间维一旦压得过狠,运动信息就丢了,画面会变得僵硬。
训练这个3D VAE的时候,除了常规的重建损失,通常还会加一项专门针对时间维的约束。原因也不难理解:如果只优化单帧重建,模型完全可以每帧都重建得很像,但它不保证帧与帧之间的连贯。加时间维约束,就是逼着编码器保留运动信息。
时空Patch:视频怎么变成Token序列
潜变量拿到之后,要送进Transformer,还得先切成token。这一步跟ViT处理图像的做法一致,只是把patch从二维升级到了三维。
假设潜变量形状是(B, C, T, H, W)。用尺寸为(pt, ph, pw)的三维patch做切分,每个patch展平后做一个线性投影,就得到一串token。
# 伪代码:三维patch化
B, C, T, H, W = latent.shape
pt, ph, pw = 2, 2, 2                # 时空patch尺寸

# 切分并展平为 (B, N, C*pt*ph*pw)
tokens = rearrange(
    latent,
    'b c (t pt) (h ph) (w pw) -> b (t h w) (c pt ph pw)',
    pt=pt, ph=ph, pw=pw
)

# 线性投影到模型隐藏维度
tokens = patch_embed(tokens)         # (B, N, D)
tokens = tokens + pos_embed_3d       # 叠加三维位置编码
接着算token数。潜变量是64×64×4,patch取2×2×2,得到的序列长度是32×32×2=2048。对比前面像素空间的16384,缩了8倍。这个倍数,就是3D VAE加patch化一起带来的收益。
位置编码这里有个细节值得留意。图像的位置编码是二维的,视频得是三维的——(t, h, w)三个方向各一套。而且它对时间维的编码方式很讲究:编码得太弱,模型分不清帧序;编码得太强,模型会把位置坐标记死,泛化到别的时长就出问题。不少实现用三维RoPE(旋转位置编码)来缓解这个矛盾。
DiT骨干:把UNet换成Transformer
早期的扩散模型用UNet做去噪骨干,靠卷积和下采样堆叠。到了视频这一代,主流方案换成了DiT(Diffusion Transformer)——用Transformer结构替代UNet。
DiT由Peebles和Xie在2023年提出,核心结论是:在扩散模型里,Transformer的scaling表现比UNet更顺——加大参数量、加大数据量,效果能稳定涨。这对视频这种需要大模型、大数据的场景很关键。Sora的技术报告里也提到用Transformer作为扩散骨干,后来一大批开源视频模型(Latte、Open-Sora、CogVideoX等)都跟进了这条路线。
| 对比项 | UNet骨干 | DiT骨干 |
|---|---|---|
| 基本算子 | 卷积 + 下/上采样 | 自注意力 + 前馈网络 |
| 感受野 | 受卷积核限制,需堆叠扩大 | 全局可见 |
| Scaling表现 | 增益较早饱和 | 随规模增长更稳定 |
| 视频适配 | 需把二维卷积扩成三维 | 直接扩展token序列长度 |
时空注意力的几种工程取舍
DiT用在视频上,绕不开一个计算复杂度问题。自注意力是O(N²),N是token数。视频的token数是T×H×W量级,全局三维注意力的开销会迅速不可接受。工程上常见的折中方案有三种。
完全三维注意力:所有token互相关注,建模能力很强,但显存消耗大,一般只在小分辨率、短时长上做实验。
时空分解注意力:把一次三维注意力拆成两步——先在同一帧内部做空间注意力,再在同一空间位置上做时间注意力。复杂度从O((T·H·W)²)降到O(T·(H·W)² + (H·W)·T²)量级。这是目前用得比较多的做法。
窗口/稀疏注意力:只在局部时空窗口内做注意力,或采用固定的稀疏模式,进一步压开销。代价是全局信息的传递要靠层数堆叠来弥补。
选哪种,本质是在"建模能力"和"算力预算"之间找平衡点。同一篇论文里的不同规模配置,往往也会换用不同的注意力方案。
按数据流向过一遍
把整条链路串起来:原始视频 → 3D VAE编码 → 潜变量(T/4, H/8, W/8)→ 三维patch化 → token序列 + 三维位置编码 → DiT堆叠(时空分解注意力)→ 预测噪声 → 迭代去噪 → VAE解码回像素。
理解这条链路的收益很实际。当你遇到生成视频显存爆了、时长拉不长、画面糊了这类问题,可以顺着链路去找瓶颈在哪一环:是VAE压缩率不够导致token太多,是注意力方案太重,还是位置编码没处理好时长泛化。定位到环节,才好对症调参。
