企业知识库问答为什么答不准?从分块到重排的检索链路调优手册
某公司的内部知识库问答上线两周,反馈开始往技术这边涌。有员工问"出差住宿标准是多少",系统给出的答案引用了两年前已经废止的那版制度,数字还是旧的。换个人问"IT-032 这个工单流程要走几步",它直接答不上来,说资料里没有相关内容——可那份流程文档明明就在库里。
遇到这种情况,很多人的反应是先去换模型。但真去翻日志会发现,模型给出的答案在它拿到的上下文里是成立的,问题出在更靠前的一环:该被检索出来的片段,压根没进到模型面前。
检索增强生成(RAG)这条链路,从文档进库到答案出口有好几段,每一段都有可调的地方。这篇按链路顺序,把每段的工程细节和参数取值理一遍。
答不准,问题多半出在检索
把 RAG 拆开看,它由两段组成:离线阶段把文档切块、编码、入库;在线阶段拿问题去检索、重排、交给模型生成。生成只是末端一步,前面检索错了,模型再强也只能在错误的材料上"合理地"编。
所以排查顺序应该从后往前反着来:先看检索到的片段对不对,再看分块是否合理,然后看解析有没有丢内容。多数"答不准"的案例,根因都能落到这三层里。
文档解析:先把格式理干净
企业文档的格式远比想象中复杂。扫描件要过 OCR,双栏排版的 PDF 直接按行抽取会把左右两栏的字交错串在一起,表格更是重灾区——一行行抽出来,表头和数据就分家了。
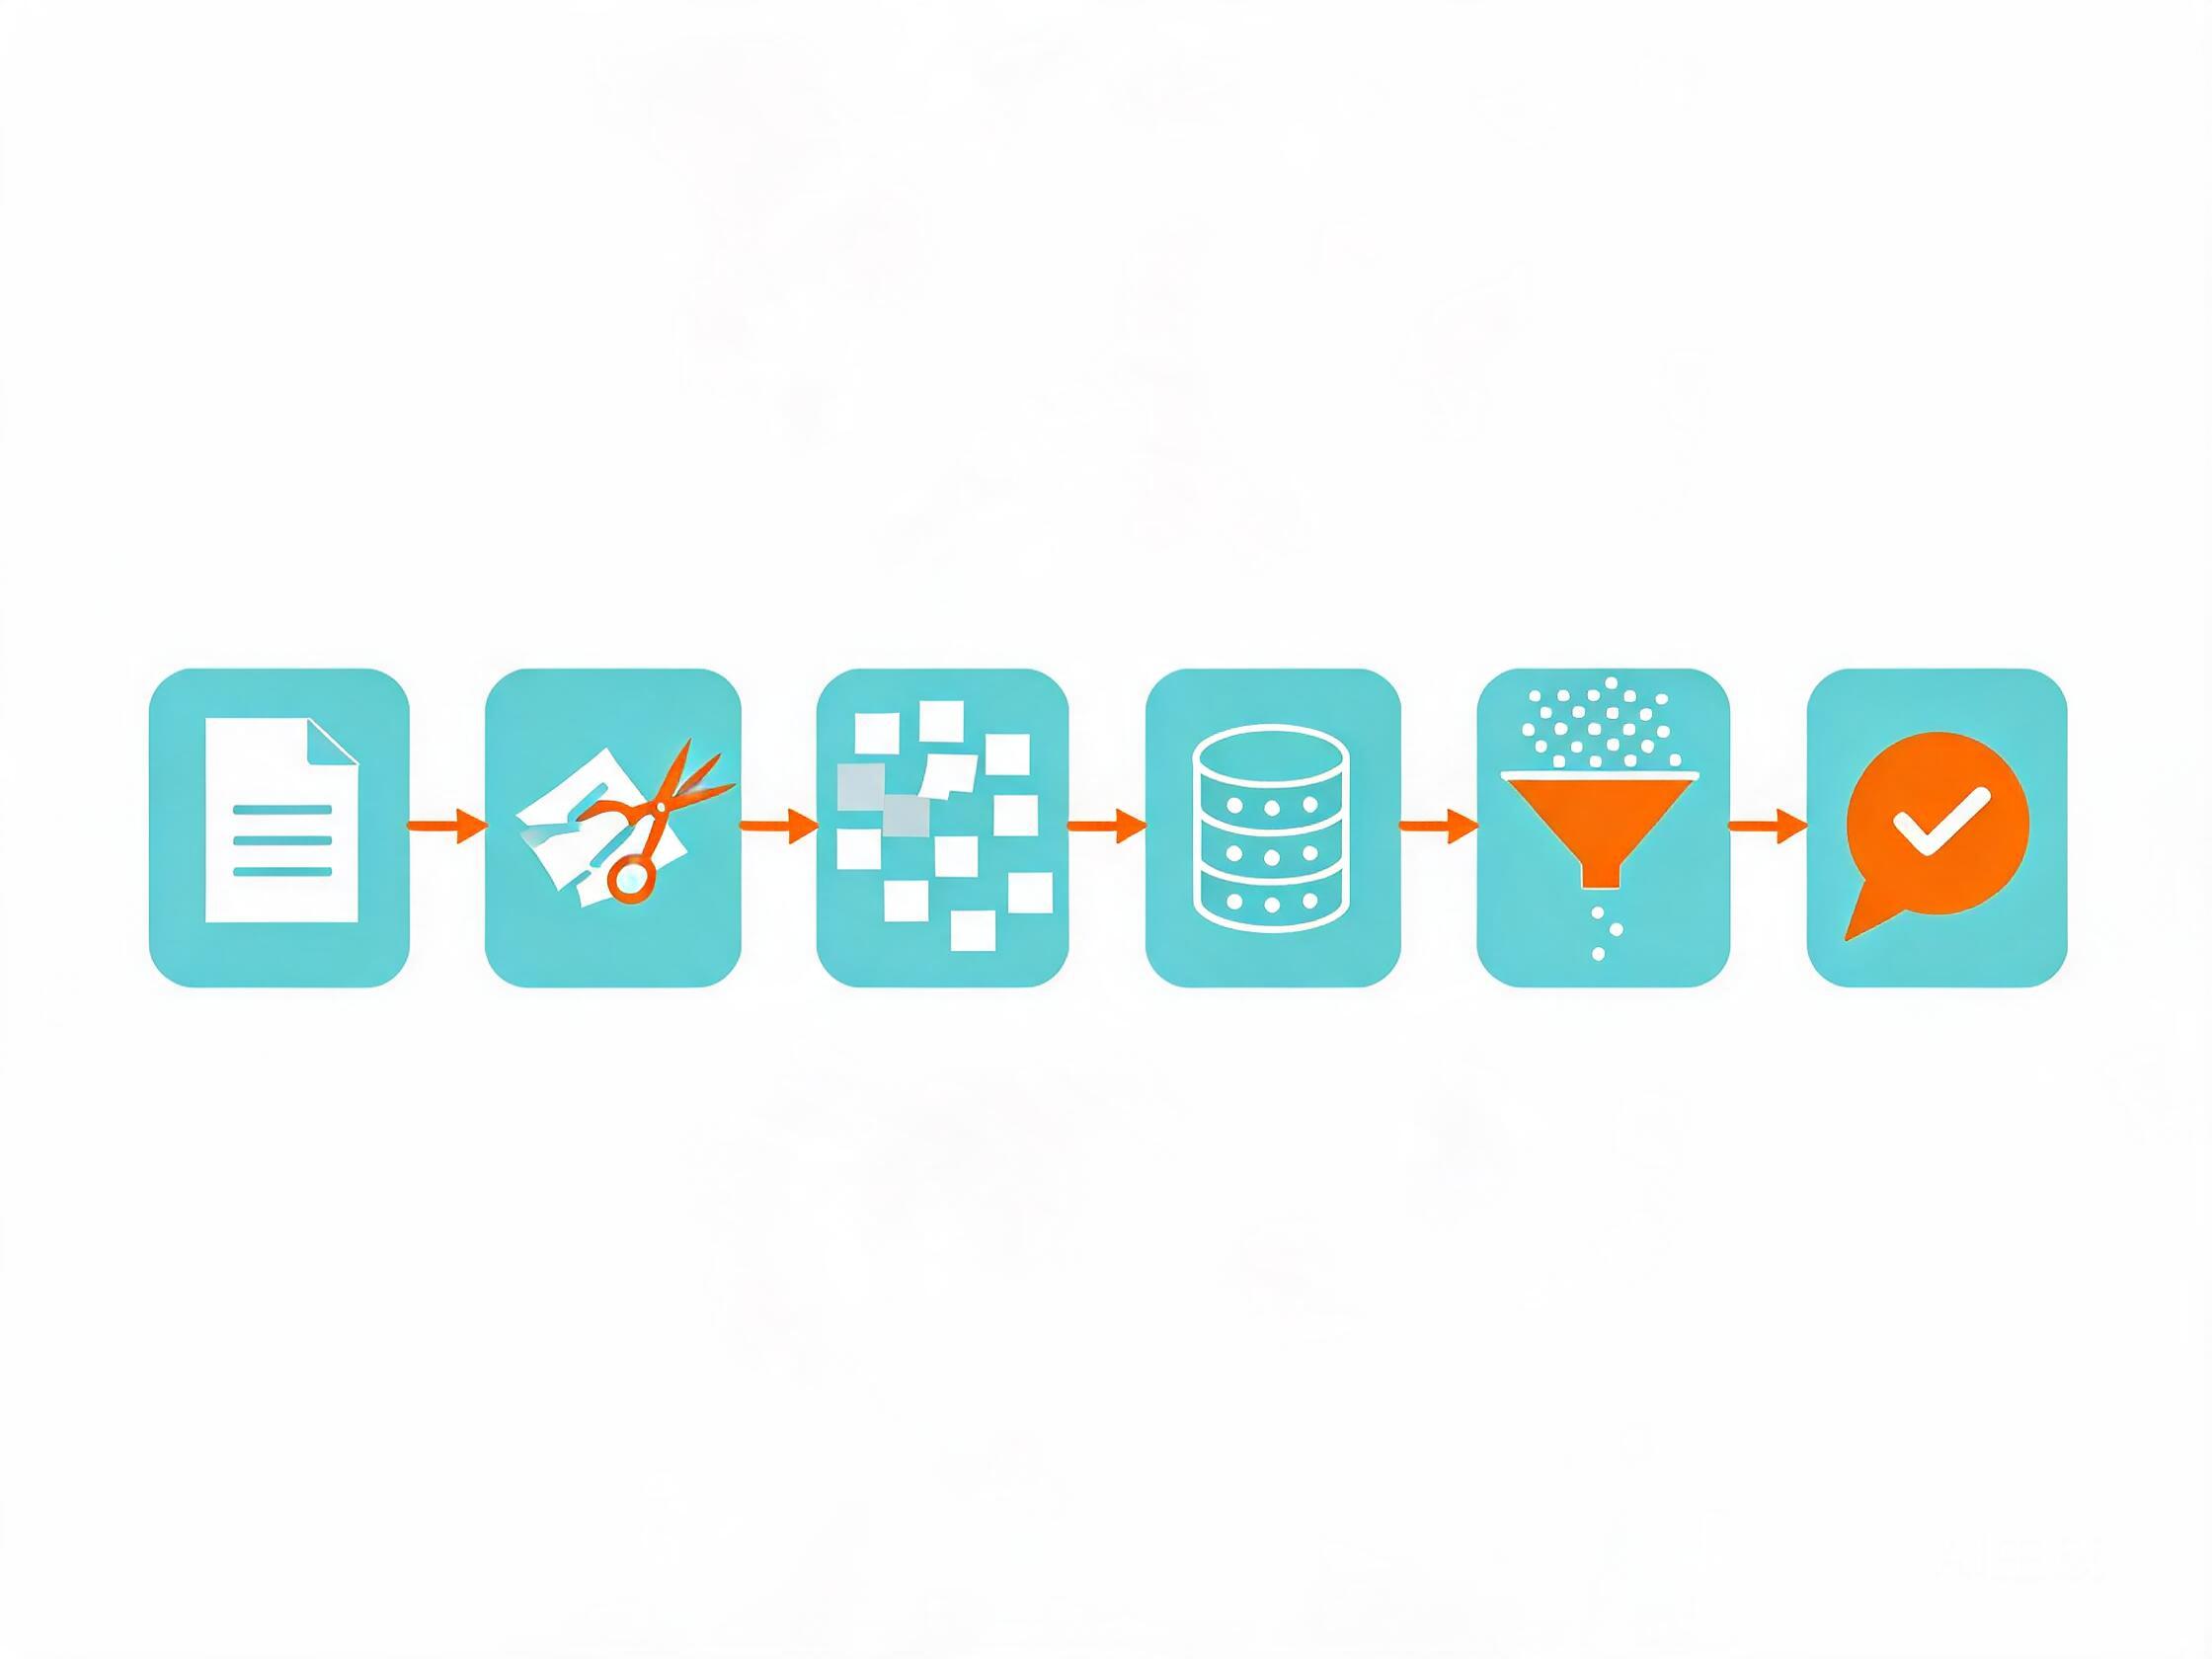
常见的处理办法是分类型走不同通道:文本型 PDF 直接抽取,双栏的先做版面分析再按栏读取,表格单独走表格识别并保留行列结构,扫描件走 OCR 并保留坐标信息用于还原顺序。
还有一个容易被忽略的字段:版本。开篇那个"引用了废止制度"的问题,根子就在新旧两版文档同时入库,检索时谁的分高就用谁。稳妥的做法是给每个文档块打上生效日期和版本号,检索阶段按时间过滤。
分块:切多大、按什么切
分块是整条链路里影响比较大、又经常被随手设一个默认值的地方。
块切得太小,一句话被腰斩,语义不完整,检索出来的片段答不了问题;切得太大,一个块里混了好几个主题,向量被稀释成一个"什么都沾一点"的平均值,反而匹配不上任何一个具体问题。
切法上,按标题层级切通常比按固定字数切稳。文档本身的结构就是天然的主题边界,顺着标题切,块内的内容天然内聚。再配合少量重叠,防止答案刚好落在切口上被截断。
# 按标题层级切块,块内保留所属章节路径
chunks = split_by_heading(doc, max_tokens=500, overlap=80)

for c in chunks:
    c.meta = {
        "doc_id": doc.id,
        "path": c.heading_path,     # 例如:第三章 > 报销标准 > 住宿
        "version": doc.version,
        "effective_date": doc.effective_date,
    }
把章节路径写进块元数据,是个成本很低但收益明显的动作。检索命中一个块时,模型能知道它出自哪一章哪一节;回答时也可以把这条路径作为引用出处返回,员工一眼就能核对。
混合检索:向量召回配关键词召回
只用向量检索,语义相近的内容能召回来,但它对精确的字符串不太敏感。制度编号、产品型号、员工工号这类型号类信息,向量模型很难把它们区分清楚——"IT-032"和"IT-023"在向量空间里可能离得很近。
反过来,只用关键词检索(BM25 这类),精确匹配没问题,但换个说法就检索不到了。员工问"住宿能报多少",文档里写的是"差旅住宿费标准",字面对不上,关键词检索就会漏。
两路一起用,各自把候选捞回来,再融合排序,覆盖度会好很多。融合常用的做法是倒数排名融合(RRF):不看两路各自的分数,只看名次。
# 两路召回
vec_hits = vector_store.search(embed(query), top_k=30)   # 语义相近
kw_hits  = bm25.search(query, top_k=30)                  # 编号、专名

# 倒数排名融合:只看名次,免疫两路分数量纲不同的问题
def rrf(lists, k=60):
    score = {}
    for lst in lists:
        for rank, doc in enumerate(lst):
            score[doc.id] = score.get(doc.id, 0) + 1 / (k + rank + 1)
    return sorted(score, key=score.get, reverse=True)

merged = rrf([vec_hits, kw_hits])[:30]
用 RRF 而不用加权求和,主要是省事:向量相似度在0到1之间,BM25 的分数可以到几十,量纲不一致,直接加权得反复调系数。换成看名次,两路的贡献天然可比,k 取60是常见经验值,对结果不算敏感。
重排:把真正相关的几条推到前面
召回阶段讲究"宁多勿少",先捞回几十条候选,但这里面混着不少擦边的。生成阶段只吃得下少数几条,如果直接把召回结果的前五条喂给模型,很可能把真正有用的那条挤在后面。
重排就是来解决这个错位的。召回用的双塔模型,问题和文档是分开编码再算距离,速度快但精度有限;重排用的交叉编码器,把问题和候选拼在一起过一遍模型,精度高得多,代价是慢,所以只对少数候选做。
# 重排:交叉编码器逐条精算相关性
final = reranker.rank(query, merged, top_n=5)
这一步的收益往往比换一个更大的生成模型更明显。原因也简单:它是直接在修正"送进模型的材料对不对"这个问题。
生成:只依据检索片段作答,并附出处
上下文拿到了,还要约束模型怎么用。提示里需要明确几件事:只依据提供的片段回答;片段里没有的,直接说不确定,不要靠常识补;每个结论后面标出引用的片段编号。
把"允许说不知道"写进提示,能压掉相当一部分编造。很多人担心这样会让回答变得保守,但在企业知识库这个场景里,一个"资料里没有相关内容"远比一个编得像模像样的错误答案安全。
参数速查表
| 环节 | 参数 | 建议取值 | 说明 |
|---|---|---|---|
| 分块 | 块大小 | 300~600 token | 太小语义不全,太大主题被稀释 |
| 分块 | 重叠长度 | 块大小的10%~20% | 防止答案落在切口处被截断 |
| 检索 | 向量召回k | 20~50 | 宁多勿少,交给重排筛 |
| 检索 | 关键词召回k | 20~50 | 补编号、型号、专有名词 |
| 融合 | RRF常数k | 60 | 经验值,对结果不敏感 |
| 重排 | 保留条数 | 3~8 | 太多会稀释重点,太少会漏 |
| 生成 | 引用标注 | 开启 | 便于人工核对与追溯 |
| 过滤 | 版本/生效日期 | 按需开启 | 避免检索到已废止的旧制度 |
怎么知道调对了
改完参数如果只靠"感觉好点了"判断,很容易反复摇摆。比较实际的做法是先攒一批真实问题当测试集——从客服记录、工单、群里问过的实际问题里挑几十条,每条标注出应该命中的文档块。
然后盯三个数。召回率:正确的那几个块有没有进到候选里,这个数上不去,后面再调都没用。命中位置:正确块在重排之后的排名,排得越靠前越好。答案忠实度:回答里的结论是否都能在检索片段里找到依据,这个靠人工抽查或另起一个模型来评判。
三个数里,召回率是地基。它低,说明问题出在解析、分块或检索策略;它高但答案还不对,才轮到去动重排和生成提示。
调优的顺序比参数本身更重要
回过头看,那条"引用了废止制度"的反馈,如果一开始就去调生成提示,无论怎么写都修不好——因为送进模型的材料本身就是过期的。
这也是这类系统调优容易走弯路的地方:生成端反馈看起来直接,改起来也快,于是大家都从那里动手;但整条链路是逐级传递的,上游丢的信息,下游补不回来。顺着"解析 → 分块 → 检索 → 重排 → 生成"的顺序往前查,先保证材料对,再谈表达好,通常比反过来省力得多。
