视频想用自己的声音配音?AI 声音克隆配音技巧与避坑
6天前16
想让视频里出现"自己的声音",却不想一句句真录,或者人在外地、环境太吵——这时声音克隆就派上用场了:录一小段你的声音,AI 学会你的音色,之后输入文字,就能用"你的声音&…
AI 配音总像机器人念稿?文字转语音配音技巧拆解
6天前16
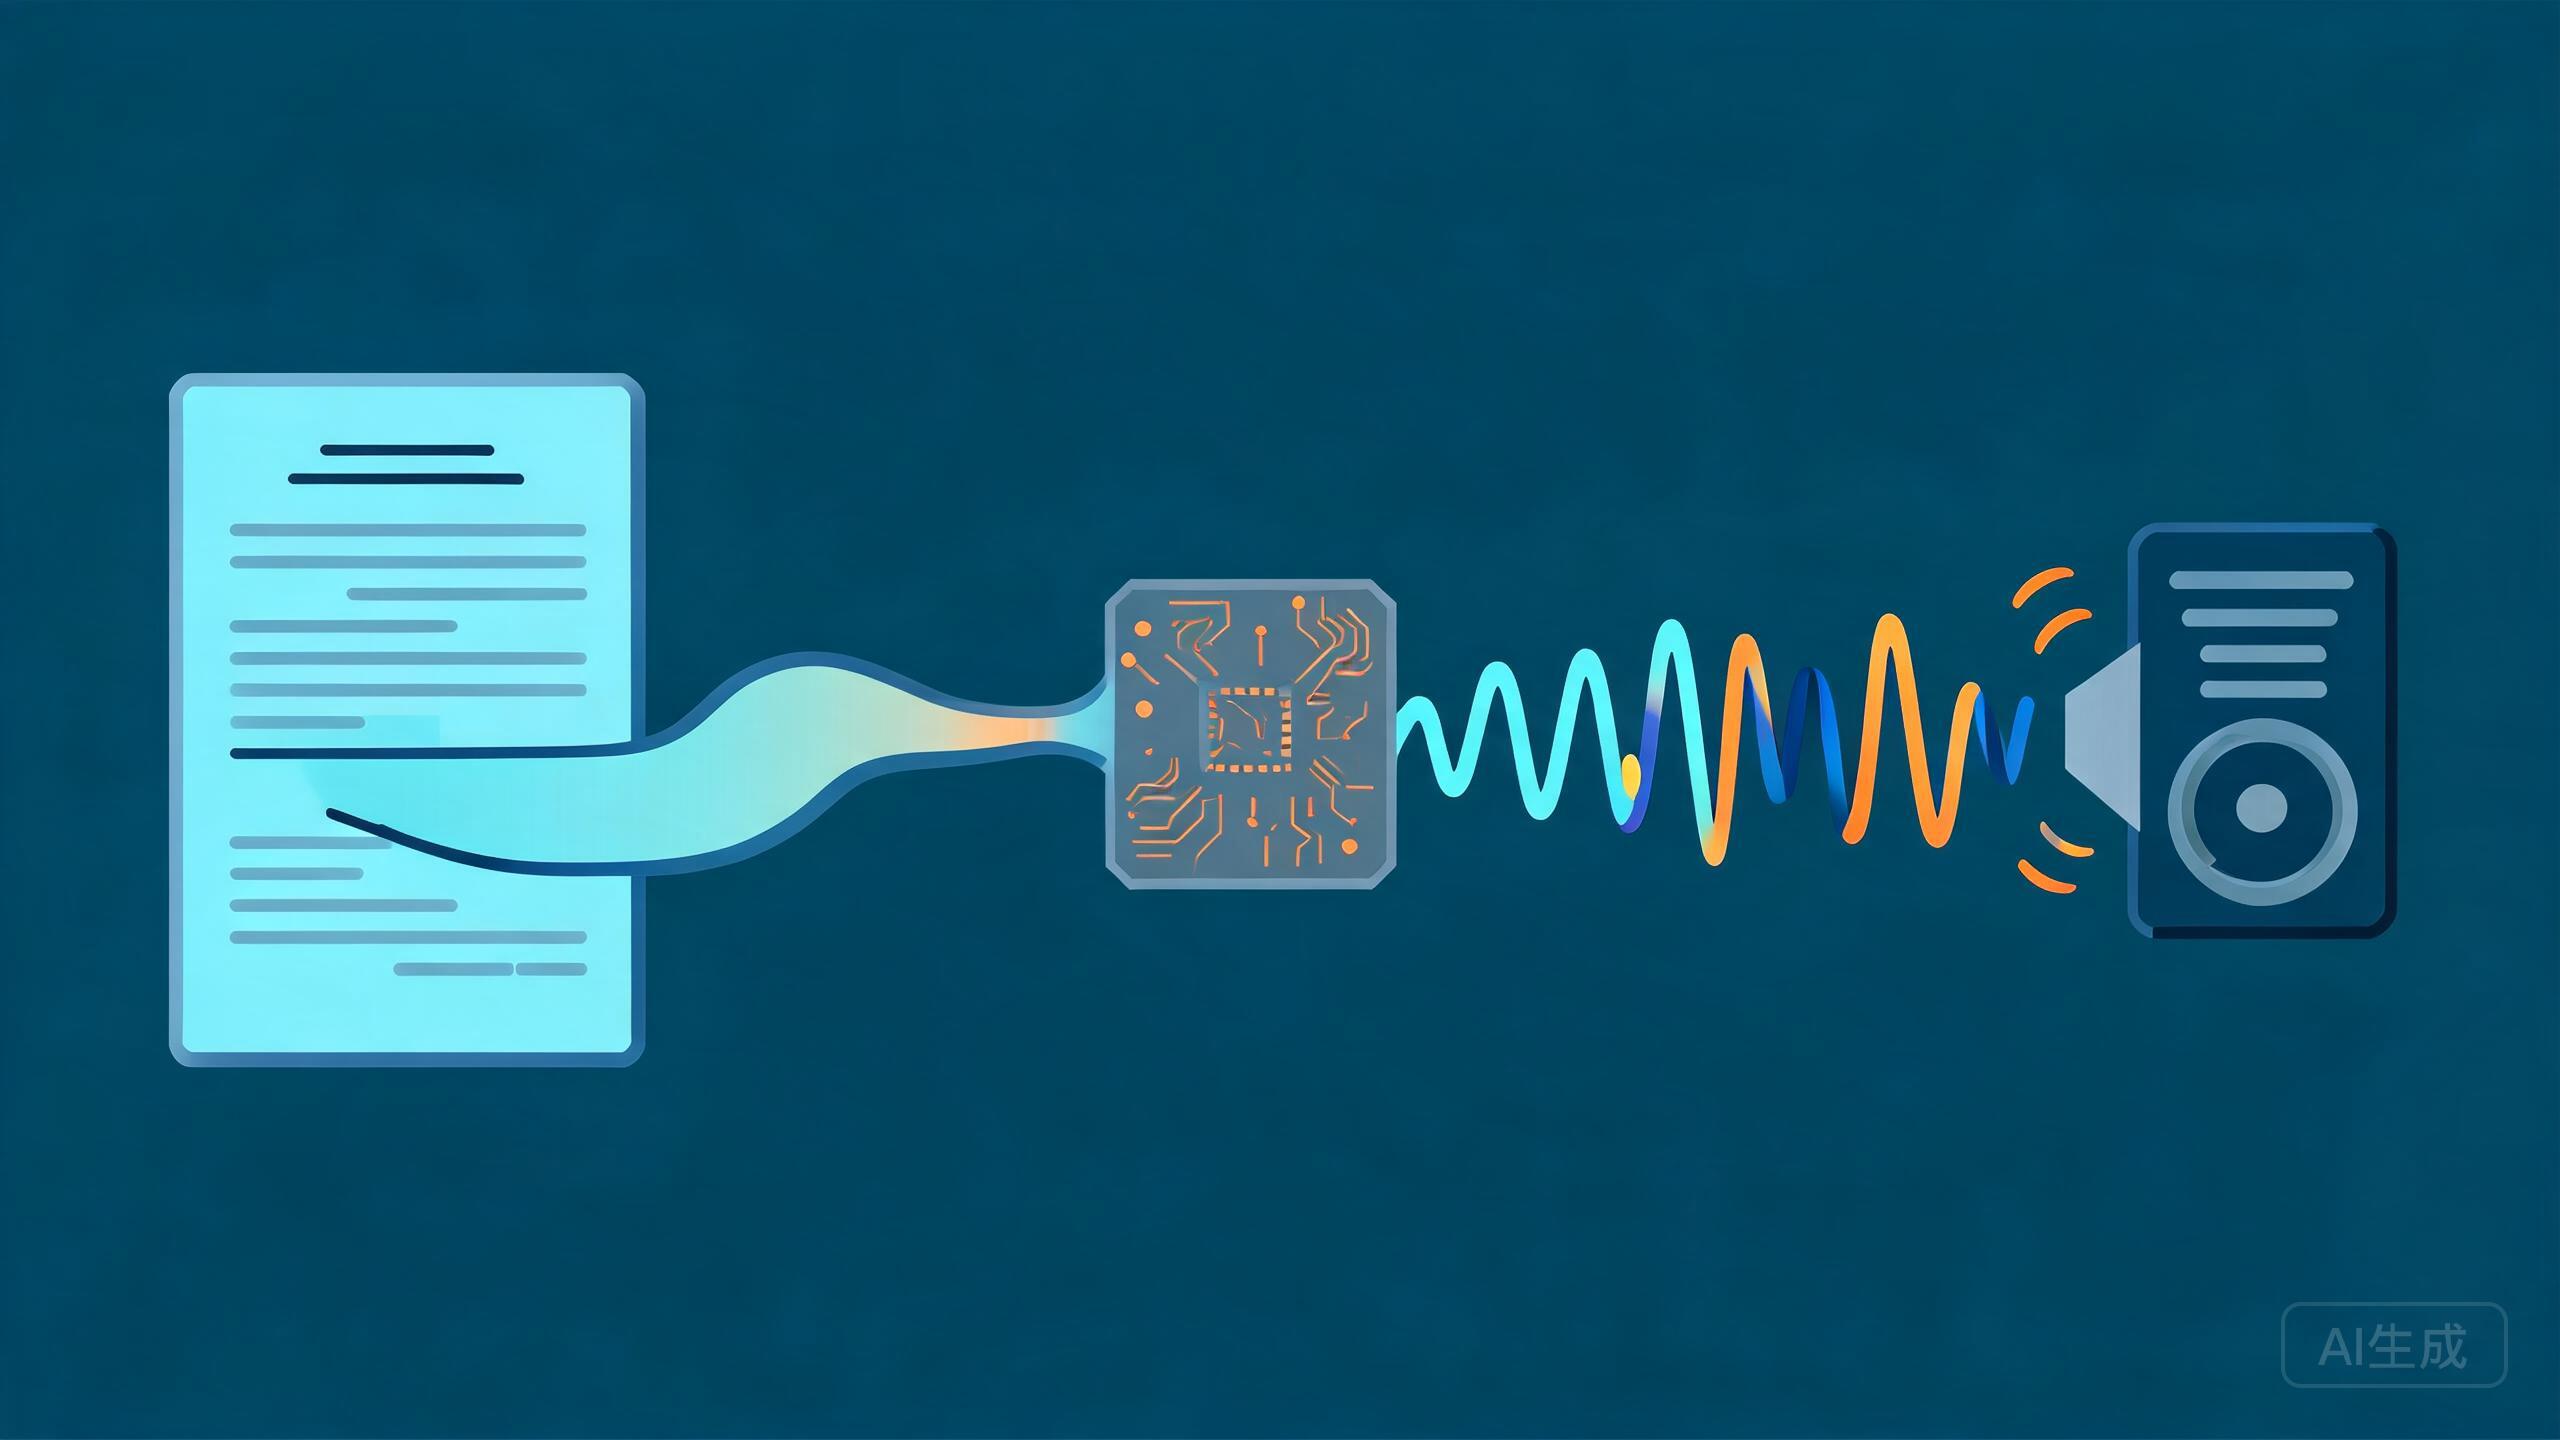
短视频、教程、企业宣传片,越来越多人在用文字转语音(TTS)给画面配音。可同样的工具,有人配出来自然得听不出是 AI,有人却是一股"念说明书"的僵硬味。差在哪?多数时候不在工具本身…
AI 视频角色总变脸?角色一致性与首尾帧控制技巧
6天前17
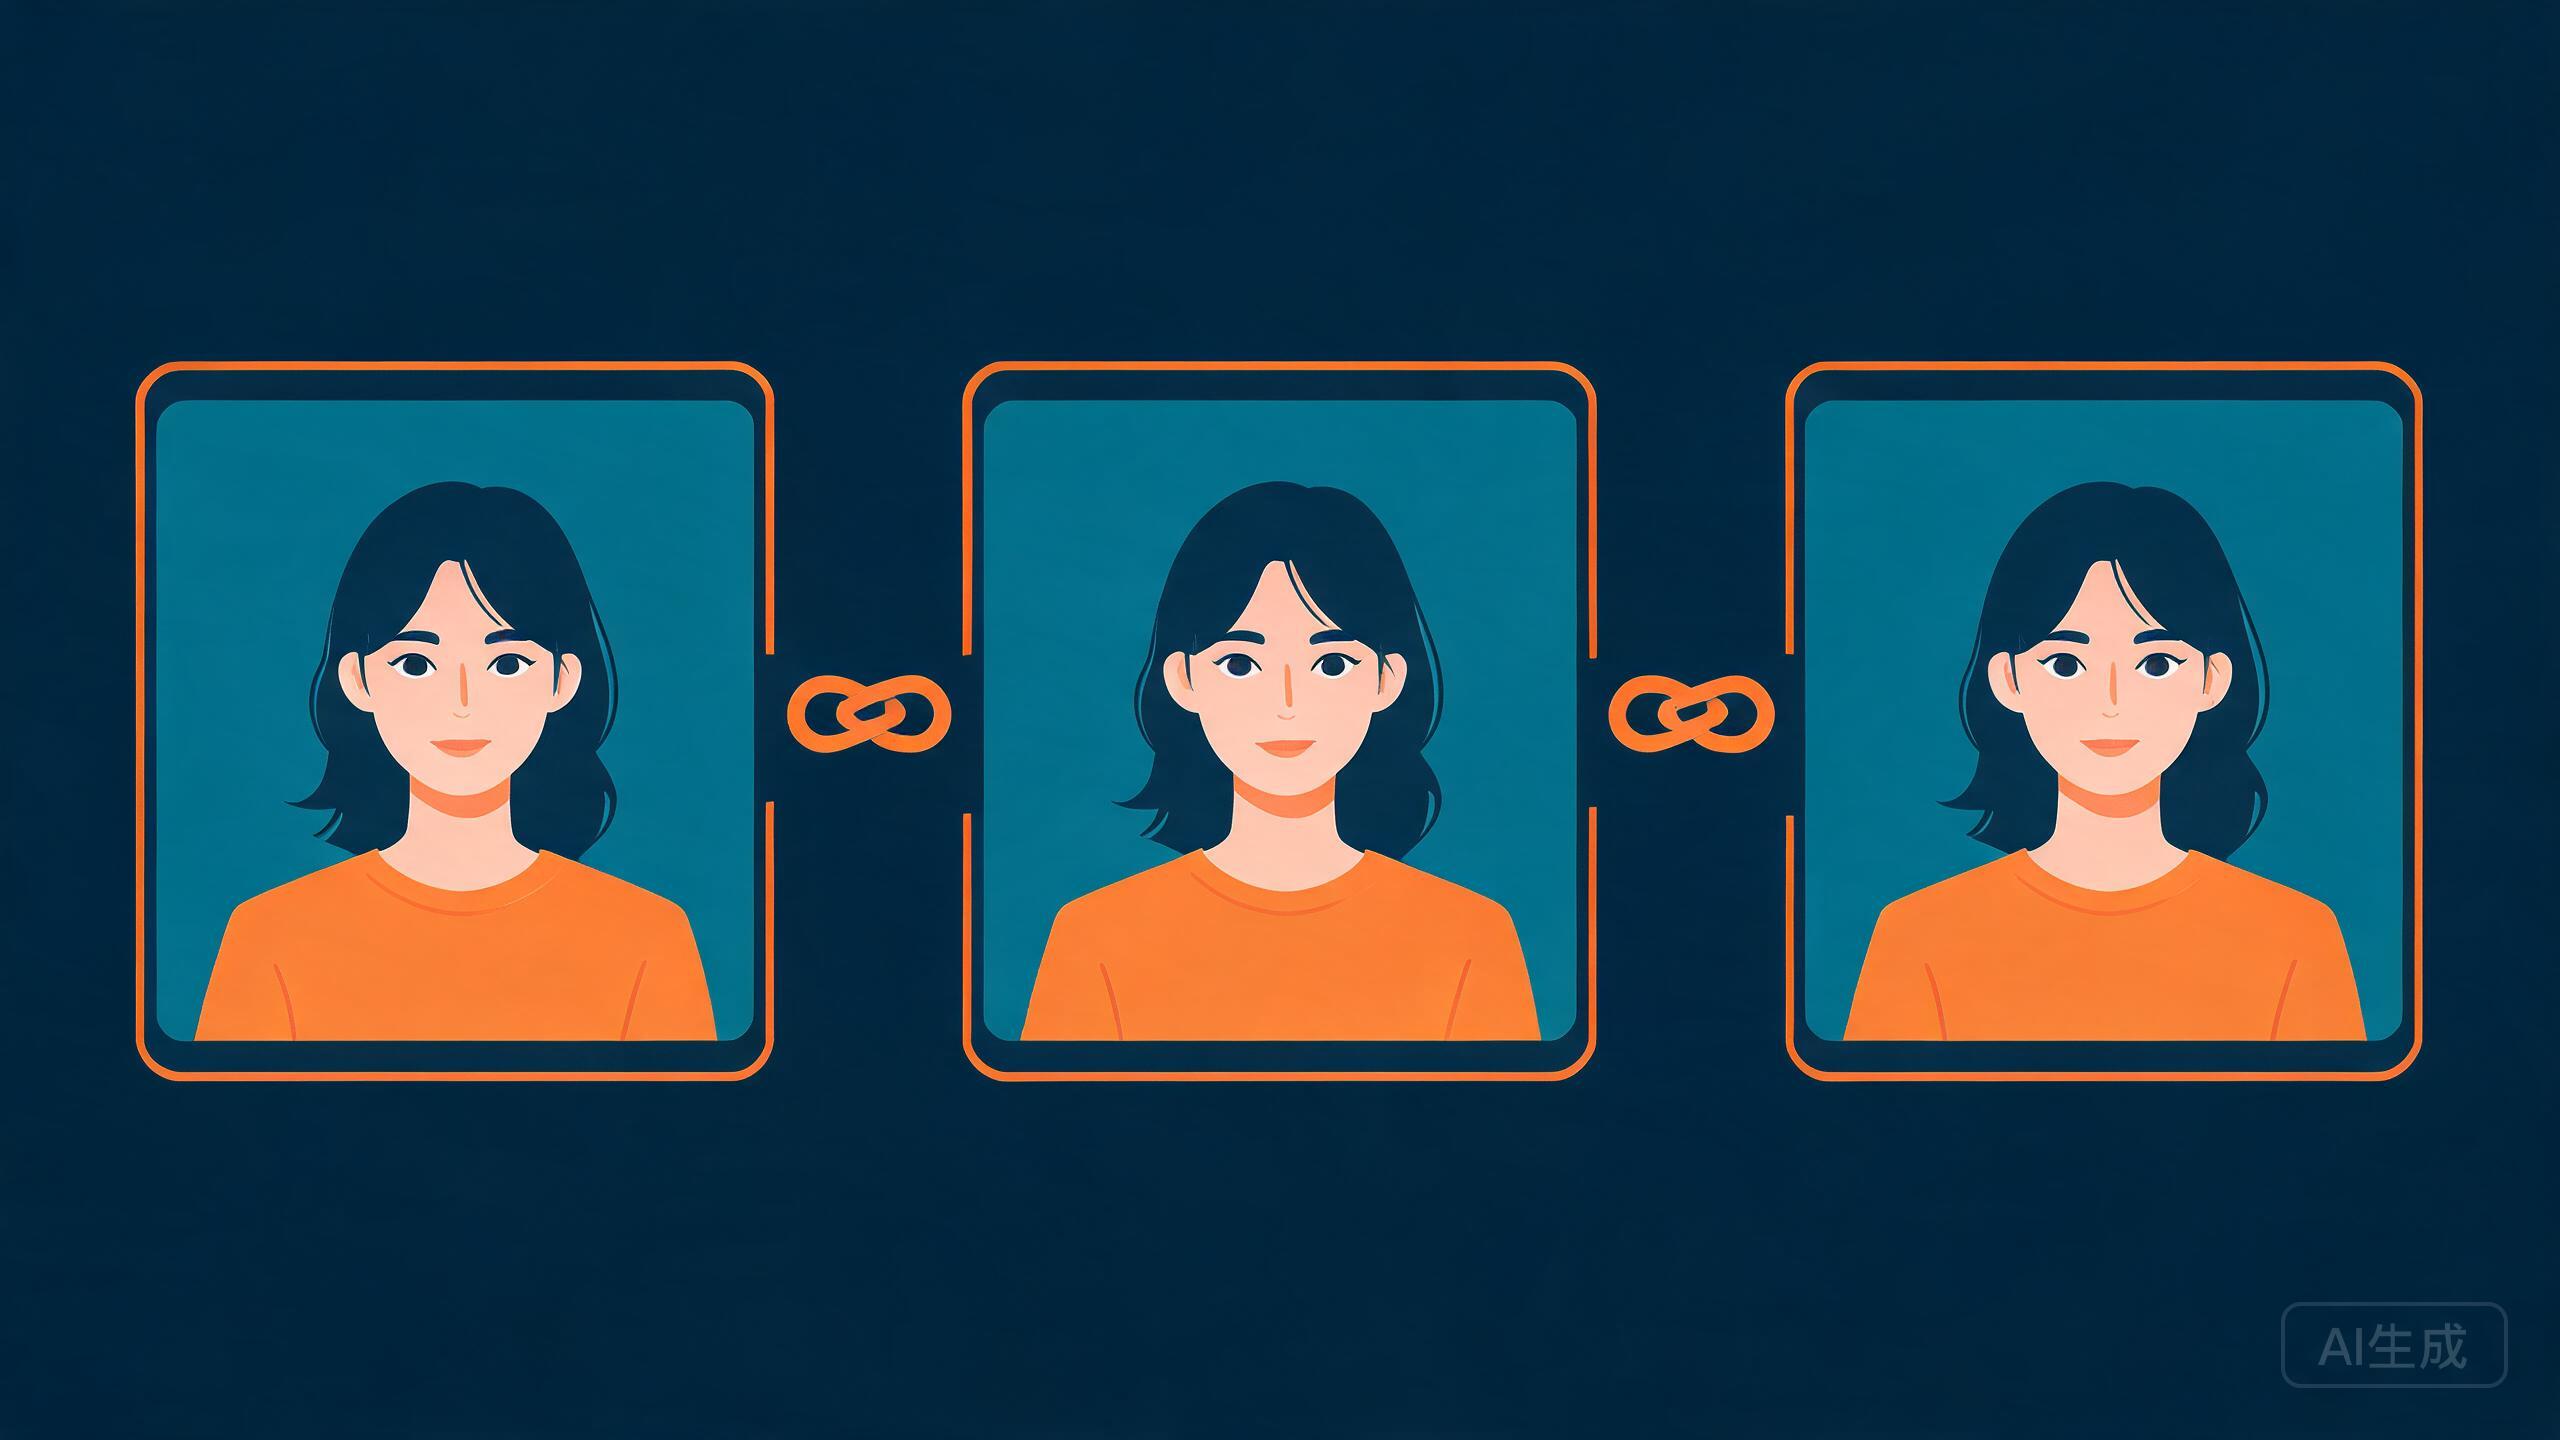
用 AI 做视频,真正劝退的不是"不像",而是"上一秒还是这个人,下一秒脸就换了"。一条几分钟的短剧,主角在镜头间来回变脸,再好的画面也救不回来。这背后是文生视…
AI 视频提示词怎么写才不糊?文生视频 Prompt 技巧拆解
6天前16
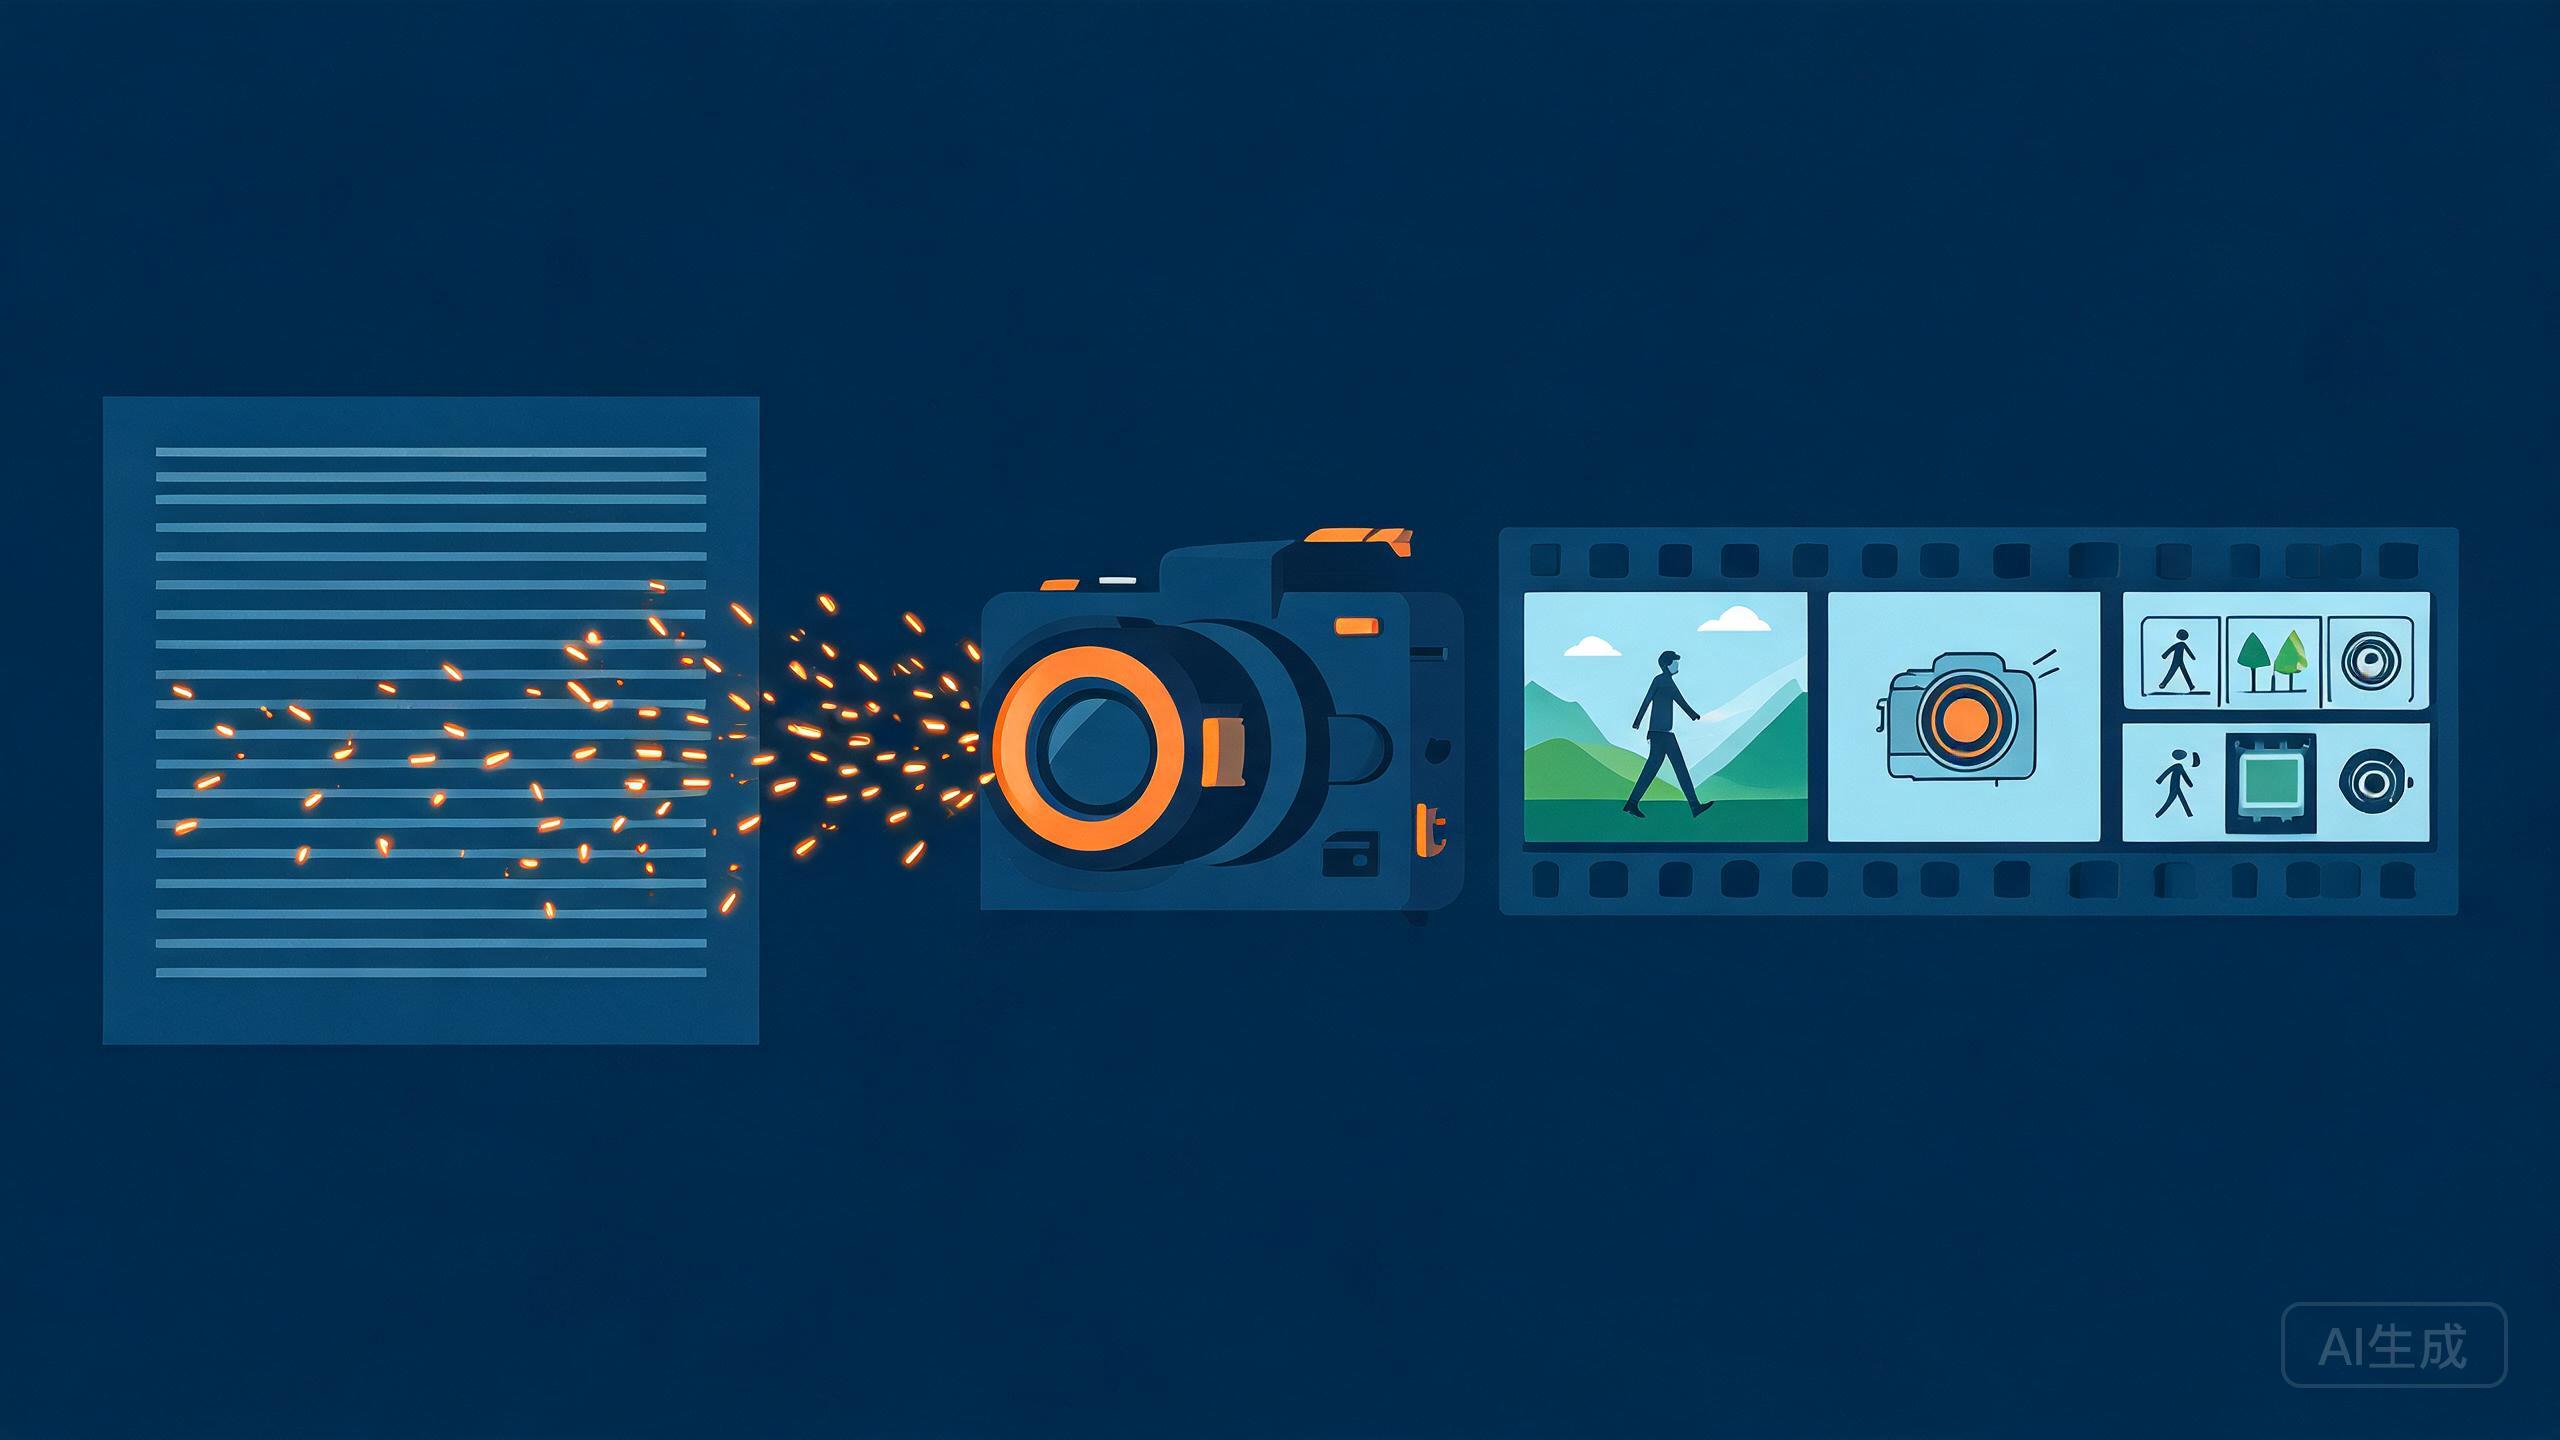
同样是文生视频,有人一句话出来的是电影感短片,有人输入一长串却得到一摊混乱抖动。差别多半不在工具,在提示词。视频提示词比图片提示词难,在于它多了一条"时间轴":不光要交代"…
Stable Diffusion 为什么能在普通显卡上跑?潜在扩散模型与 VAE 潜空间拆解
6天前17
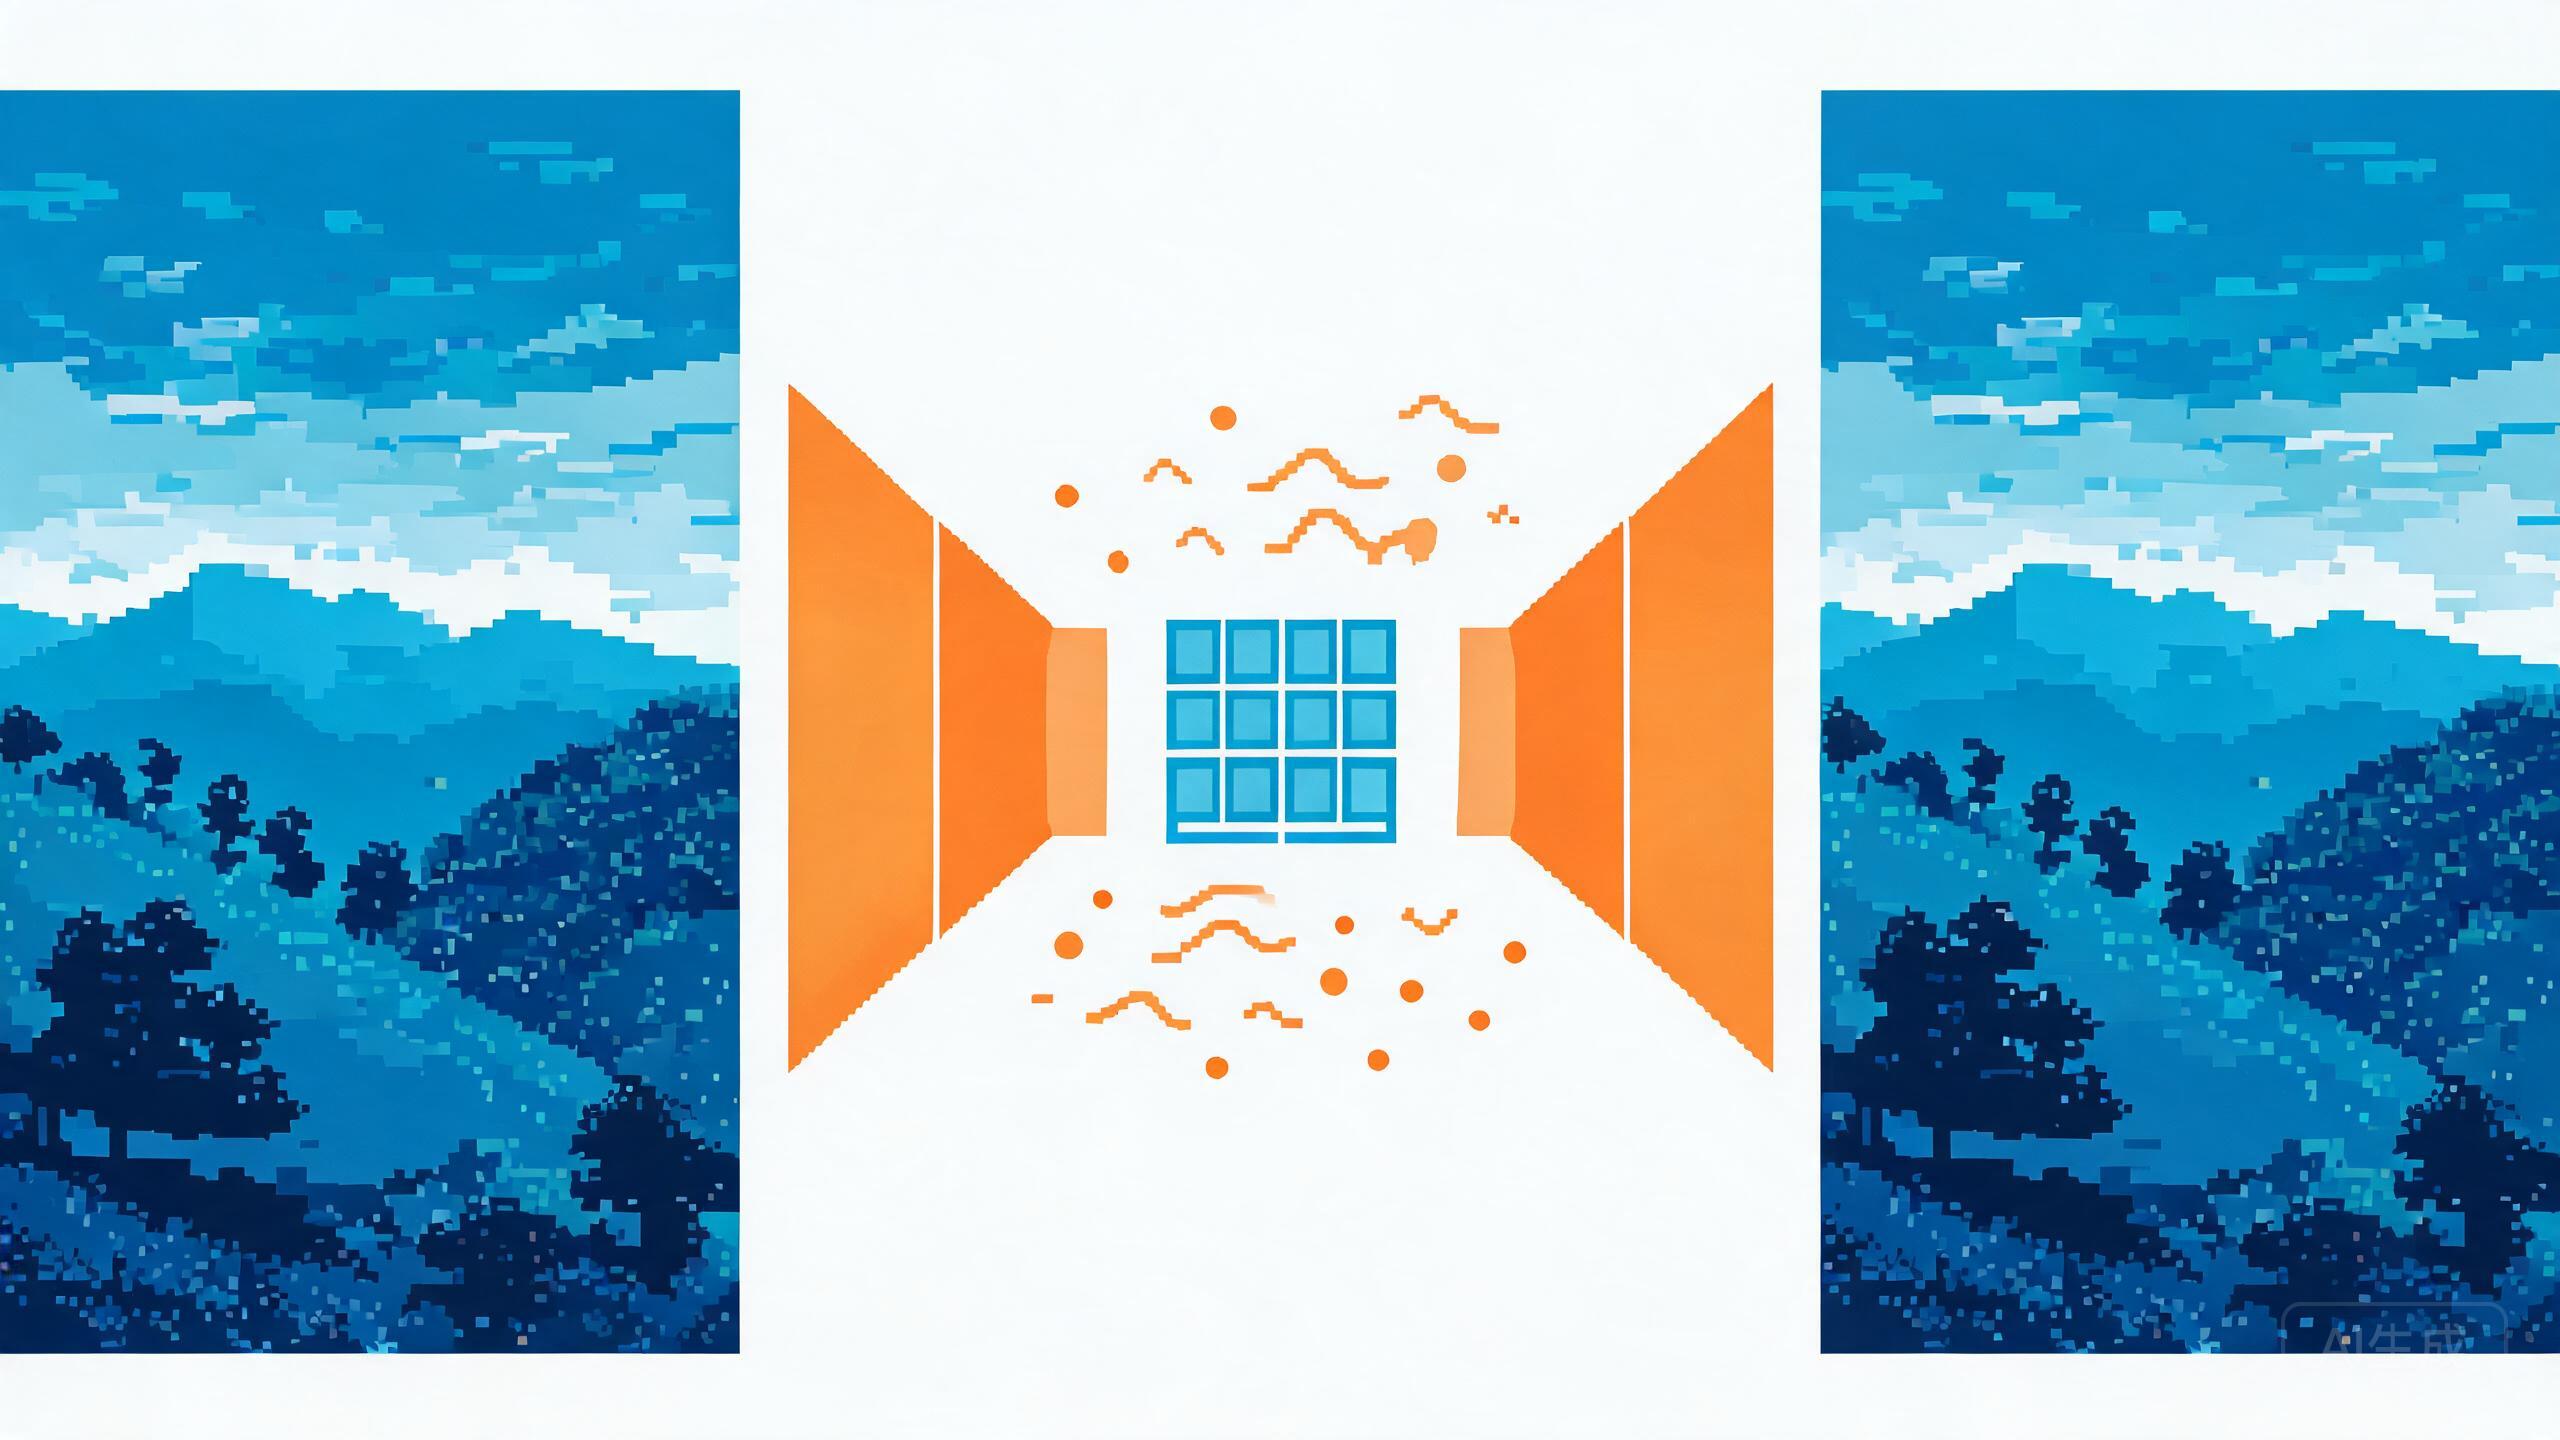
文生图模型动辄要生成 1024×1024 的大图,早期扩散模型却在"像素"上一步步算,慢得让人抓狂。Stable Diffusion 能在一张普通显卡上跑,靠的正是一个关键改造——…
AI 画图的底层:扩散模型 DDPM 加噪与去噪原理拆解
6天前17
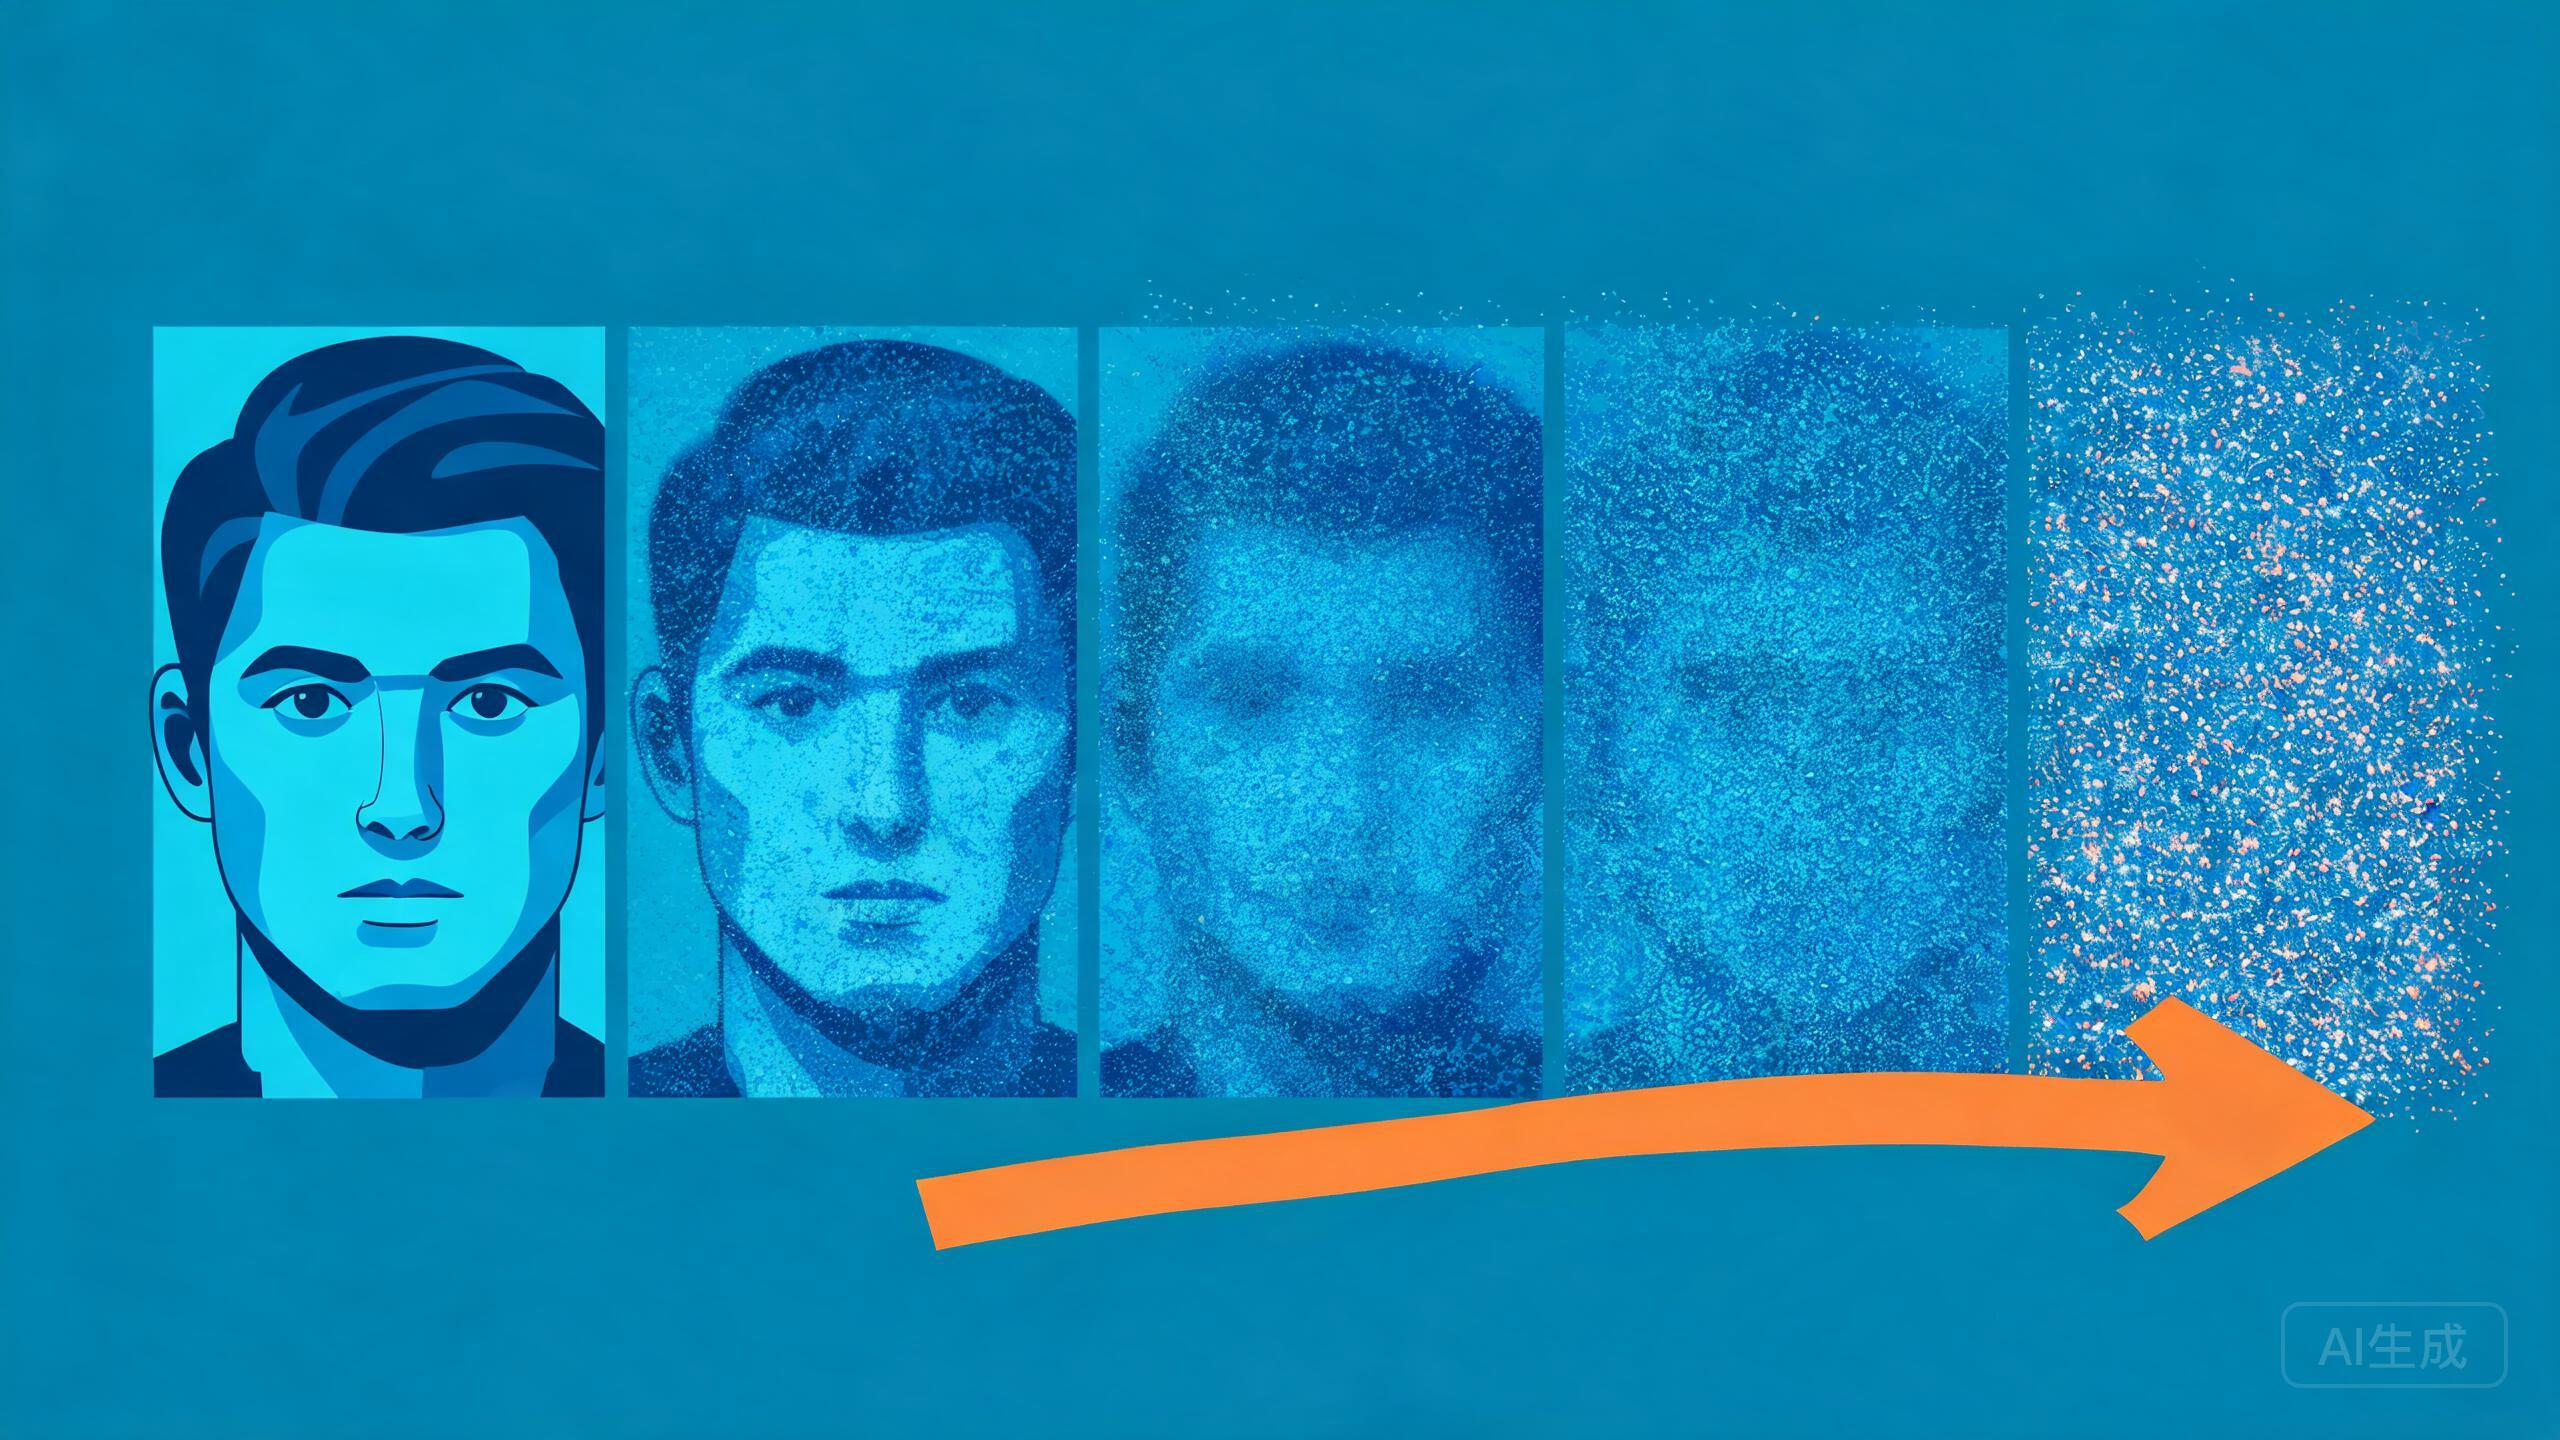
文生图模型看着像"凭空"画出一张图,可它真正干的事,其实朴素得让人意外:它先把一张清晰图片一步步毁成纯噪声,再学着一路把噪声"还原"回图片。学成了还原,也就学会…
Transformer 的心脏是怎么算的?自注意力机制与多头注意力原理拆解
6天前16
大模型、翻译、代码补全,背后都立着一台叫 Transformer 的引擎,而这台引擎的心脏,是一套叫"自注意力"(Self-Attention)的机制。它解决的是一个朴素却要命的问…
为什么大模型参数这么多却不太慢?MoE 混合专家架构原理拆解
1周前 (10-05)18
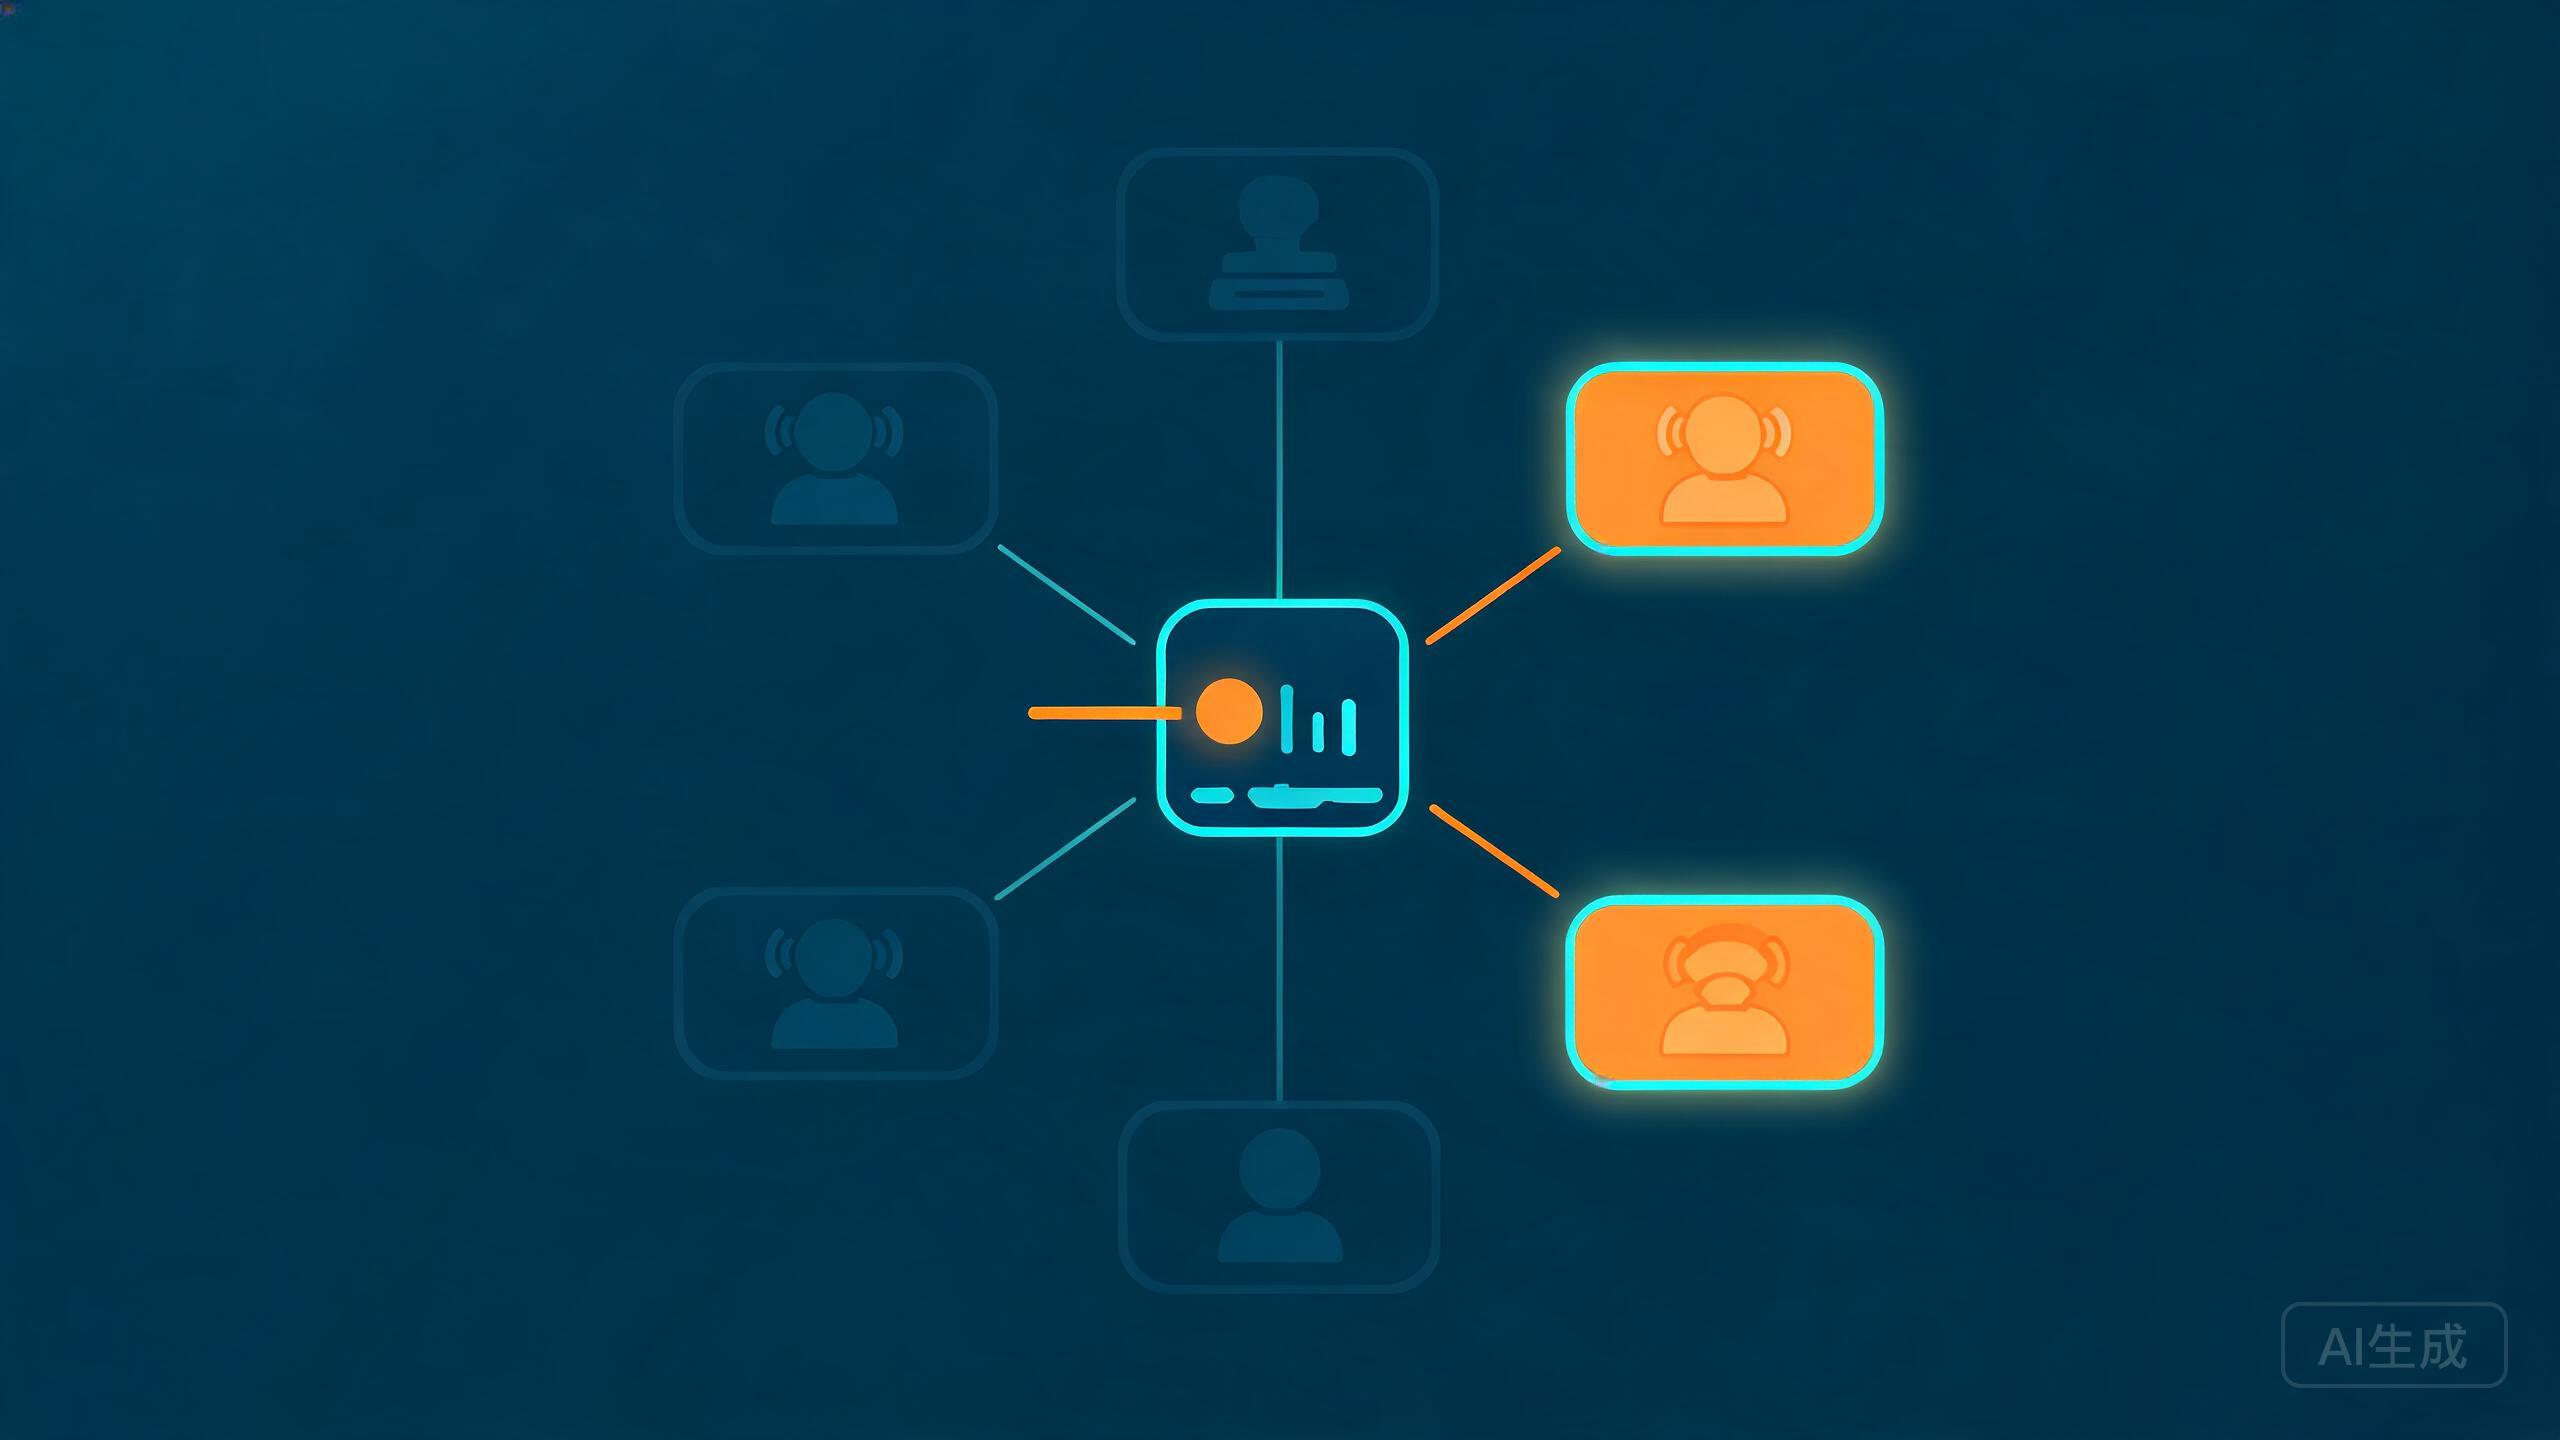
这几年有个奇怪的现象:有的模型总参数大得吓人,跑起来却没想象中那么慢,训练成本还压得很低。背后的关键,很多时候就是"MoE"这三个字母——混合专家(Mixture of Exper…
大模型是怎么缩进手机里也能跑的?模型量化原理拆解(INT8/INT4 量化技术详解)
1周前 (10-05)19
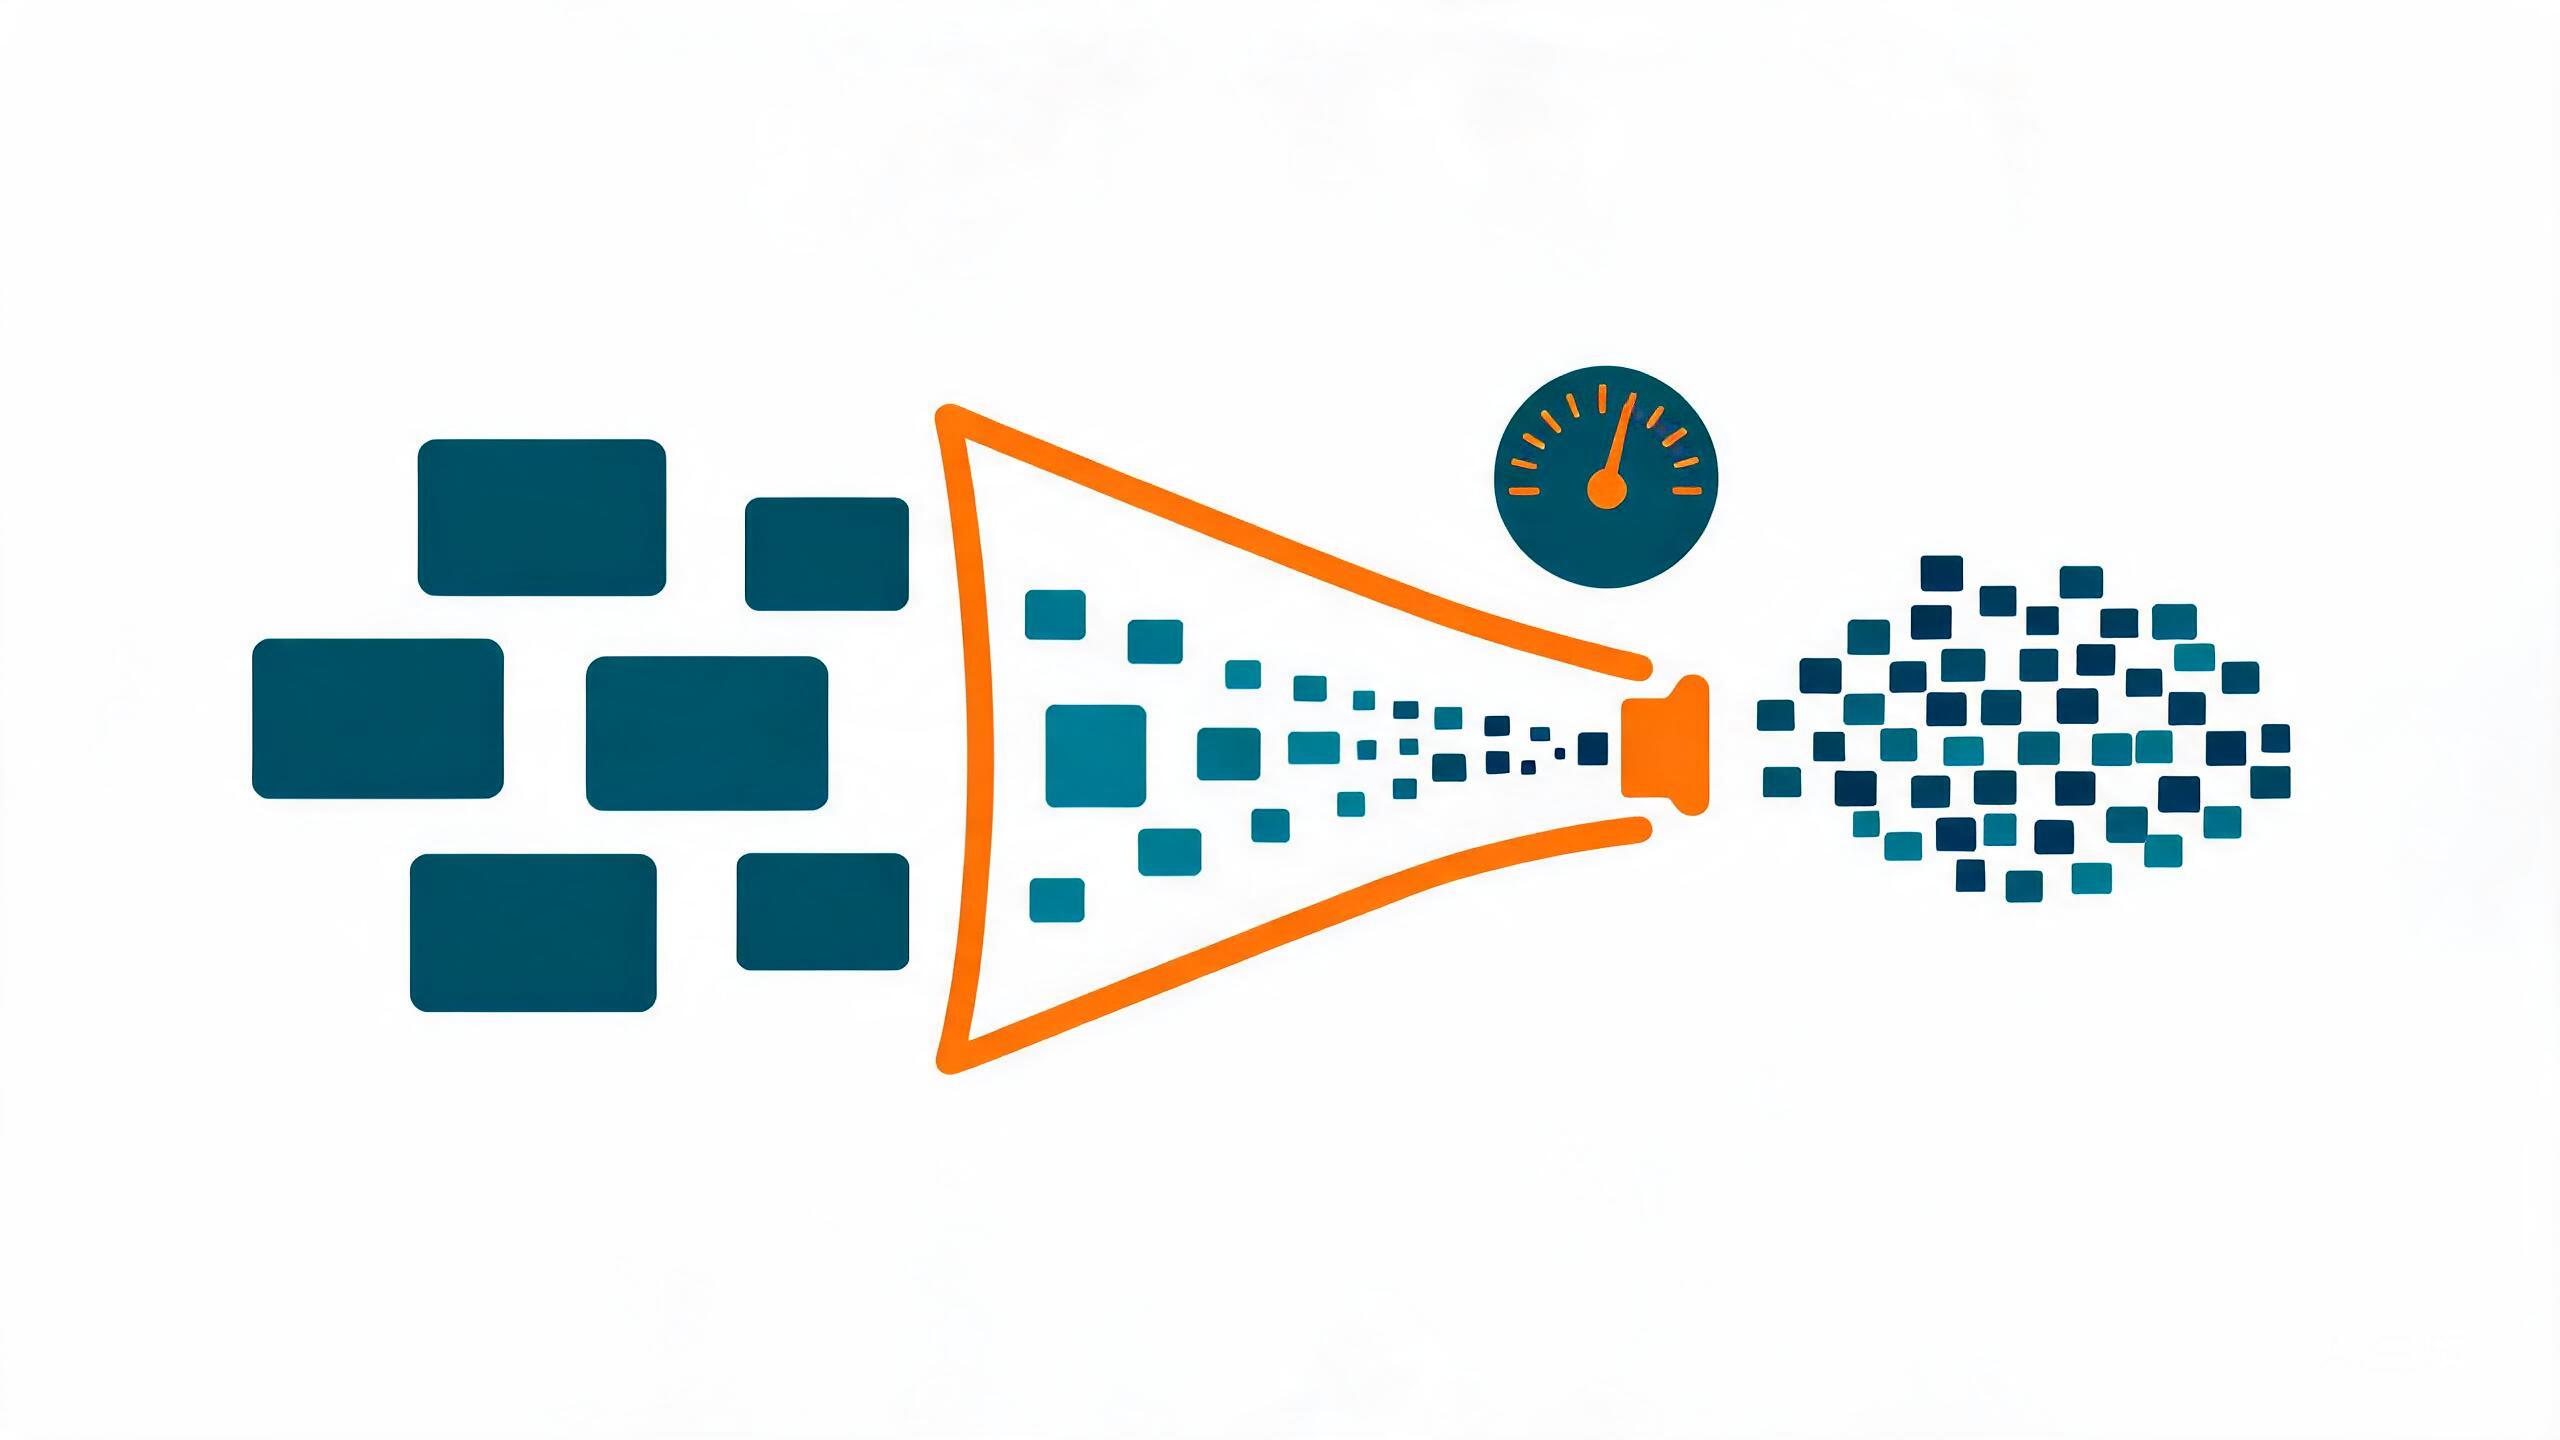
一个 70 亿参数的模型,原始权重动辄要几十 GB 显存,凭什么本地电脑能跑、手机也能跑?答案绕不开两个字——量化。它几乎是大模型从"服务器里的大家伙"变成"人人能下载&…